
Synonyme-Pflege im Shop: Manuelle Kontrolle plus AI-Vorschläge
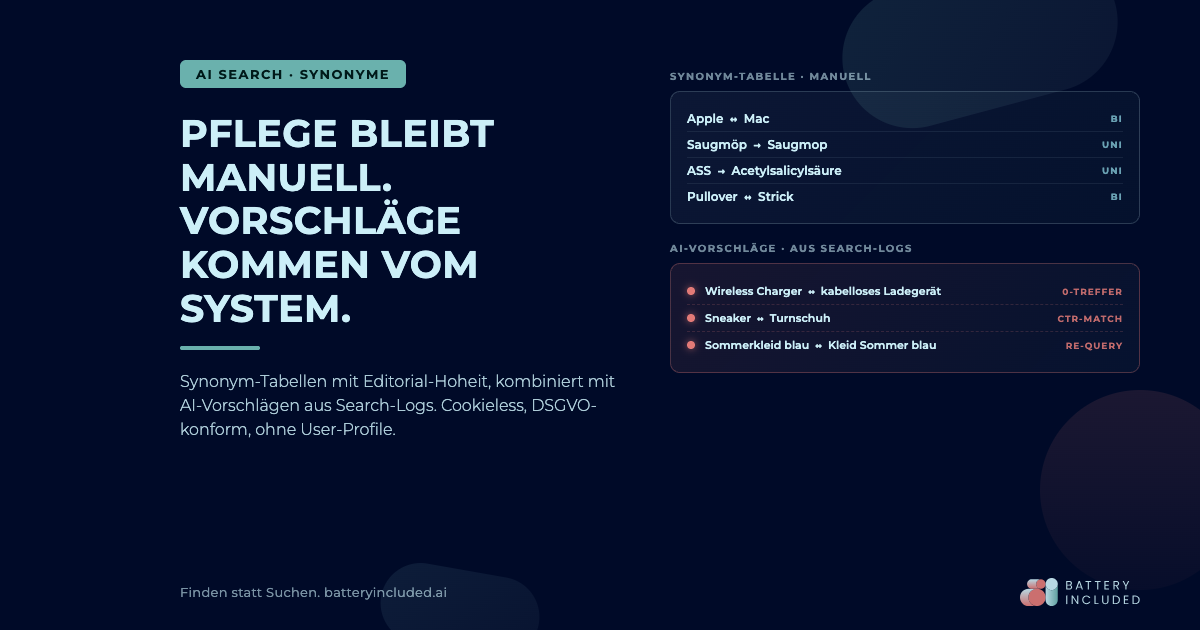
Klassische Synonym-Tabellen sind brutal pflegeintensiv. BatteryIncluded kombiniert pflegbare Tabellen mit AI-Vorschlägen aus echten Search-Logs: Null-Treffer-Suchen, Re-Formulierungen und Klick-Konvergenz werden zu Editorial-Vorschlägen, die das Team approved oder rejected. Manuelle Kontrolle bleibt erhalten, Pflege-Last sinkt.
Wo der Pflege-Aufwand wirklich entsteht
Viele Category-Manager fragen sich: Warum frisst die Synonym-Pflege im Shop so viel Zeit, obwohl die Tabelle doch nur ein paar Spalten hat? Weil jede statische Synonym-Tabelle einen manuellen Eintrag für jede Marke, jeden Tippfehler und jeden Trend verlangt und der Realität dabei strukturell hinterherhinkt. Das folgende Beispiel aus einem DACH-Shop zeigt, wo dieser Aufwand konkret entsteht.
Es ist Mittwochnachmittag in einem mittelgroßen DACH-Shop für Haushaltselektronik, der Operations-Lead sitzt vor einer Excel-Tabelle. Spalte A enthält Suchterme, Spalte B die zugewiesenen Synonyme, Spalte C einen Zeitstempel der letzten Pflege. Die Tabelle hat etwa zweitausenddreihundert Einträge, der älteste ist von 2022, der jüngste von vor drei Wochen. Im Filter-Feld läuft eine Suche nach "Saugmop", weil das Customer-Care-Team gemeldet hat, dass die Such-Anfrage "Saugmöp" zu null Treffern führt, obwohl der Shop drei passende Produkte führt. Die Pflege-Tabelle ist die einzige Stelle, an der dieses Synonym hinzugefügt werden kann.
Bis das Synonym live ist, vergehen vier bis sieben Werktage. Zwischenliegend gibt es eine Validierung durch Marketing, eine Freigabe durch SEO, einen Deploy in das Search-Backend und einen Cache-Refresh. In der Zwischenzeit laufen zwischen vierzig und hundertzwanzig Such-Anfragen mit dem Tippfehler-Term auf null Treffer. Manche davon waren Kauf-Absichten, manche waren Recherche-Klicks. Die Statistik dazu liegt im Behavior-Report, der in einer Woche im Marketing-Meeting besprochen wird.
Diese Pflege-Mechanik ist nicht ein Versäumnis des Teams. Sie ist die Konsequenz einer Architektur, in der das Synonym-Wörterbuch eine statische Tabelle ist, die Pflege ein manueller Prozess und die Trainings-Daten ein Reporting-Artefakt. Jede neue Marke, jeder neue Produkttyp, jeder Saison-Trend, jeder Regionalismus, jede Slang-Variante, jeder Tippfehler-Cluster verlangt einen manuellen Eintrag in dieser Tabelle. Wer eintausend SKUs führt, kommt mit einer Handvoll Pflege-Stunden pro Monat aus. Wer fünfzigtausend SKUs in zwanzig Kategorien hat, baut sich eine Vollzeit-Stelle nur für die Synonym-Pflege auf, und selbst diese Stelle hinkt der Realität immer hinterher.
Die strukturelle Antwort ist nicht "weg mit der Pflege", sondern "Pflege plus AI-Vorschläge". Die Synonym-Tabelle bleibt der Ort der Wahrheit, die Editorial-Hoheit bleibt beim Team, aber die Vorschläge für neue Einträge kommen aus der Search-Log-Analyse, aus dem Behavior-Stream und aus der semantischen Schicht. Diese Mechanik haben wir im Beitrag zu GA4-Transaktionsdaten als Such-Signal für das Ranking beschrieben. Der vorliegende Artikel überträgt das gleiche Grundprinzip auf die Synonym-Schicht. Statt einer Tabelle, die in Excel altert, eine Tabelle, die täglich Vorschläge aus der Realität bekommt und die das Team in einem Editorial-Workflow durchgeht.
Warum die rein manuelle Tabelle in der Praxis kollabiert
Startet eine manuelle Synonym-Tabelle nicht eigentlich mit gutem Wirkungsgrad?
Eine Synonym-Tabelle hat in den ersten Monaten eines Shops einen guten Wirkungsgrad. Die ersten zweihundert Einträge decken die häufigsten Tippfehler und Synonyme der Top-Kategorien ab. Der Pflege-Aufwand bleibt überschaubar, das Team sieht die Verbesserung in den Conversion-Reports. Die ersten Wochen liefern den klassischen Quick Win, der die Tabelle als operativen Standard etabliert.
Drei bis sechs Monate später beginnt die Erosion. Der Shop wächst auf zehntausend SKUs, das Sortiment streckt sich in neue Kategorien, eine neue Saison startet, eine TikTok-Trend-Welle bringt neue Begriffe ins Such-Feld. Die Tabelle wächst auf tausend, dann auf zweitausend Einträge. Jeder Eintrag braucht eine Pflege-Entscheidung: bi-direktional oder uni-direktional, stark gewichtet oder schwach gewichtet, mit oder ohne Filter-Kontext. Die Pflege-Zeit pro Eintrag bleibt konstant, die Anzahl der Einträge wächst linear, der Pflege-Aufwand wächst entsprechend.
Spätestens nach einem Jahr hat sich die Tabelle in drei Schichten geteilt. Erste Schicht: die heißen Einträge, die regelmäßig verwendet werden und deren Aktualität das Team aktiv überprüft. Zweite Schicht: die alten Einträge, die einmal angelegt wurden, deren Sortiment-Bezug nicht mehr stimmt, die aber niemand löscht, weil das Risiko von Conversion-Verlust groß erscheint. Dritte Schicht: die fehlenden Einträge, die in der Such-Log-Liste auftauchen, aber noch keinen Pflege-Vorgang gesehen haben. Die dritte Schicht ist statistisch die größte. Sie liefert die meisten verpassten Conversion-Chancen und ist gleichzeitig die unsichtbarste, weil sie nur in den Behavior-Reports sichtbar wird, die niemand aktiv liest.
Diese drei-Schichten-Pathologie ist universell. Sie betrifft jeden Shop, der die Synonym-Pflege als rein manuelle Disziplin betreibt, unabhängig von der Plattform, vom Sortiment oder von der Team-Größe. Sie ist die Konsequenz davon, dass eine Tabelle keine Such-Logs liest, keine Behavior-Daten kennt und keine semantische Nachbarschaft versteht. Sie verlangt, dass der Mensch alles findet, alles bewertet, alles einträgt. In der Praxis findet der Mensch das Heiße und das Alte, aber nicht das Fehlende. Genau das Fehlende ist das, wo die Conversion-Lücke entsteht.
Synonym-Klassen, die jeden Shop betreffen
Welche Synonym-Klassen tauchen eigentlich in jeder Shop-Suche auf?
Bevor wir über AI-Vorschläge sprechen, lohnt ein Blick auf die Synonym-Klassen, die in jeder Shop-Suche vorkommen. Sie unterscheiden sich strukturell und brauchen unterschiedliche Pflege-Logiken.
Erste Klasse: Marken-Synonyme. Apple und Mac, Adidas und adi, Samsung und sammy. Diese Synonyme sind oft bi-direktional, weil ein User, der nach "Apple" sucht, das gleiche Sortiment wie ein User, der nach "Mac" sucht, sehen will. Marken-Synonyme sind in der Pflege stabil, weil sie an der Marken-Identität hängen und sich selten ändern. Sie sind das Fundament der Synonym-Tabelle und werden in der Praxis manuell vom Team gepflegt, weil sie strategisch wichtig sind.
Zweite Klasse: Produkt-Typ-Synonyme. Pulli, Pullover, Sweater, Strick. Bluse, Hemd, Shirt. Sneaker, Turnschuh, Trainer. Diese Synonyme sind in der Praxis bi-direktional, aber mit Vorsicht: ein "Hemd" ist nicht immer ein "Shirt", weil die Konnotation in DACH bei "Hemd" formaler ist als bei "Shirt". Wer naiv synonymisiert, mischt Casual und Business in den Such-Ergebnissen, was die Conversion senkt statt sie zu heben. Die Pflege braucht eine Klassen-Differenzierung, die manuell oder durch eine semantische Nachbar-Analyse aus der Behavior-Schicht erfolgt.
Dritte Klasse: Tippfehler-Synonyme. Saugmöp statt Saugmop, Wischmop statt Wishmop, Geschirrspüler statt Geschirspüler. Diese Klasse ist die zahlenmäßig größte. In einem Shop mit fünfzigtausend Suchen pro Monat tauchen typisch dreihundert bis fünfhundert unterschiedliche Tippfehler-Varianten in den Logs auf. Die Tippfehler-Klasse überschneidet sich strukturell mit der Fehlertoleranz-Schicht, die wir im Beitrag zur Fehlertoleranz in der Shop-Suche im Detail behandelt haben. Wenn die Fehlertoleranz mit Edit-Distance, Phonetik und Layout-Distanz arbeitet, fangen viele dieser Fehler automatisch ab, ohne dass sie als Synonyme gepflegt werden müssen. Bleibt eine Rest-Menge an Fehlern, die strukturell sind und nicht mit Edit-Distance auflösbar (zum Beispiel "Goldener Reiter" statt "goldener Retriever" bei einer Tier-Foto-Suche), die als bewusstes Synonym-Paar gepflegt werden müssen.
Vierte Klasse: Akronyme und Abkürzungen. ASS und Acetylsalicylsäure, USB-C und Typ C, Wlan und WiFi. Diese Klasse ist meist uni-direktional, weil das Akronym in das Vollwort expandiert wird, aber nicht zwangsläufig umgekehrt. Wer nach "ASS" sucht, will Acetylsalicylsäure-Produkte sehen. Wer nach "Acetylsalicylsäure" sucht, sucht spezifisch und will nicht das gesamte Schmerzmittel-Sortiment sehen. Die Asymmetrie ist wichtig und wird in der Praxis oft als bidirektional fehlkonfiguriert, was zu unscharfen Treffer-Listen führt.
Fünfte Klasse: Regionalismen und Slang. Brötchen in Norddeutschland, Semmel in Bayern, Weckle in Baden-Württemberg. Brause in einigen Regionen, Limo in anderen. Diese Klasse ist regional differenziert, und ein Shop mit DACH-weiter Auslieferung braucht die Synonyme alle drei. Wer nur in Bayern verkauft, kann auf das norddeutsche Synonym verzichten. Diese regionale Komponente wird in der Pflege oft übersehen, weil die Search-Logs aggregiert sind und die regionale Verteilung nicht direkt zeigen.
Sechste Klasse: Mehrwort-Synonyme. Kabelloses Ladegerät, Wireless Charger, Induktions-Ladegerät, Qi-Lader. Diese Klasse ist technisch anspruchsvoll, weil das Synonym über mehrere Token läuft und die naive Wort-für-Wort-Expansion nicht funktioniert. Mehrwort-Synonyme verlangen eine eigene Token-Strategie, die wir im Beitrag zu Tokenseparatoren in der Shop-Suche im Detail behandelt haben. Die Mehrwort-Synonym-Pflege ist die anspruchsvollste der sechs Klassen, weil sie sowohl Token-Logik als auch semantische Klassifikation braucht.
Diese sechs Klassen sind nicht erschöpfend, aber sie decken den größten Teil der real auftretenden Synonym-Bedarfe ab. Jede Klasse braucht eine eigene Pflege-Logik. Die Tabelle, die alle sechs Klassen in eine einheitliche Spalte presst, verliert die Klassen-Spezifika und produziert systematische Pflege-Fehler.
Auto-Discovery aus Search-Logs: wo der AI-Vorschlag entsteht
Woher kommen die AI-Vorschläge eigentlich, aus einem generischen Sprachmodell?
Die Quelle für AI-Vorschläge ist nicht ein generisches Sprachmodell, das deutsche Synonyme aus seinem Trainings-Korpus auswirft. Die Quelle ist die eigene Search-Log-Historie des Shops. Sie zeigt empirisch, welche Such-Terme welche Treffer-Klicks generieren, welche Such-Terme zu null Treffern führen und welche Such-Terme in derselben Session direkt aufeinander folgen.
Drei Muster in der Search-Log-Analyse liefern den größten Synonym-Vorschlag-Wert. Erstes Muster: Null-Treffer-Suchen mit anschließender Erfolgssuche. Ein User sucht "Saugmöp", bekommt null Treffer, sucht im gleichen Session-Verlauf "Saugmop" und klickt auf ein Produkt. Dieses Muster ist ein starkes Signal, dass "Saugmöp" und "Saugmop" Synonyme sind. Der AI-Vorschlag-Algorithmus extrahiert dieses Muster aus dem Log, bündelt es mit ähnlichen Beobachtungen aus anderen Sessions und legt einen Synonym-Vorschlag im Editorial-Backlog ab.
Zweites Muster: parallele Such-Treffer-Konvergenz. Zwei verschiedene Such-Terme führen statistisch zu Klicks auf dieselbe Treffer-Menge. "Pullover" und "Strick" liefern beide hohe Klick-Raten auf die gleichen Produkte. Dieses Muster ist die Evidenz, dass die beiden Terme in der Wahrnehmung der User austauschbar sind, auch wenn die Sprachmodell-Logik sie nur als verwandt klassifiziert. Der AI-Vorschlag-Algorithmus berechnet die Treffer-Mengen-Schnittmenge und schlägt einen Synonym-Eintrag vor, sobald die Schnittmenge eine Konfidenz-Schwelle übersteigt.
Drittes Muster: aufeinanderfolgende Sessions mit unterschiedlichen Such-Termen. Ein User sucht "Kleid Sommer blau" mit niedrigen Klick-Raten, formuliert die Anfrage um zu "Sommerkleid blau" und bekommt höhere Klick-Raten. Dieses Muster zeigt eine Re-Formulierung, die in der Sprach-Konvention für den User die gleiche Intention war, in der technischen Suchlogik aber unterschiedlich behandelt wurde. Der AI-Vorschlag-Algorithmus extrahiert diese Re-Formulierungs-Sequenzen und schlägt eine Phrase-Synonymisierung vor, die in der Mehrwort-Klasse landet.
Die drei Muster werden in der Praxis nicht einzeln, sondern in einem Scoring-Schema kombiniert. Jeder Synonym-Vorschlag bekommt einen Konfidenz-Wert, der sich aus der Anzahl der Beobachtungen, der Stärke des Behavior-Signals und der semantischen Nachbarschaft zusammensetzt. Vorschläge unterhalb einer Schwelle werden in der Editorial-Pipeline nicht angezeigt, um das Team nicht mit Rauschen zu überfluten. Vorschläge oberhalb der Schwelle landen in einem Backlog, der täglich aktualisiert wird.
Wichtig: die Search-Log-Analyse ist DSGVO-konform aggregiert. Pro Suchterm wird die Klick-Verteilung aller Sessions summiert, ohne dass User-IDs oder Session-IDs in die Aggregat-Tabelle eingehen. Diese Cookieless-Architektur haben wir im Beitrag zur DSGVO-konformen KI-Suche im Detail beschrieben. Die Synonym-Vorschläge sind ein zweiter Anwendungsfall derselben Behavior-Foundation, die auch das Ranking-Lernen versorgt.
Bi-Directional oder uni-direktional: die Asymmetrie sauber abbilden
Was muss ich pro Synonym-Eintrag als Erstes entscheiden?
Eine zentrale Pflege-Entscheidung pro Synonym-Eintrag ist die Richtung. Wer "Apple" und "Mac" als bi-direktionales Paar pflegt, sieht für beide Anfragen die gleichen Treffer. Wer "Mac" als uni-direktionalen Ausdruck von "Apple" pflegt, sieht für "Mac" alle Apple-Produkte, aber für "Apple" nur die Apple-Produkte ohne Mac-Spezifika.
Die richtige Wahl hängt von der semantischen Asymmetrie ab. Marken-Synonyme sind in der Regel bi-direktional, weil die Begriffe austauschbar sind. Akronym-Vollwort-Paare sind in der Regel uni-direktional, weil das Vollwort spezifischer ist als das Akronym. Tippfehler-Synonyme sind in der Regel uni-direktional, weil der korrekte Term das Ziel der Korrektur ist und der Tippfehler kein eigenständiges Konzept ist.
Die Asymmetrie ist nicht immer offensichtlich. "Pulli" und "Pullover" sind in der gesprochenen Sprache austauschbar, aber in der Sortiments-Klassifikation eines Shops könnte "Pullover" ein Oberbegriff sein und "Pulli" ein Slang-Term, der nur eine Untergruppe der Pullover meint. Eine bi-direktionale Pflege würde in diesem Fall die Treffer-Listen verwässern. Eine uni-direktionale Pflege von "Pulli" hin zu "Pullover" würde die Such-Anfrage "Pulli" auf das gesamte Pullover-Sortiment ausweiten, aber die Anfrage "Pullover" nicht auf den Pulli-Slang reduzieren.
In der Praxis wird diese Entscheidung pro Eintrag getroffen, aber selten dokumentiert. Die meisten Synonym-Tabellen haben eine Spalte für die Richtung, die in der Eile der Pflege oft falsch gesetzt wird. Eine ML-Schicht kann hier helfen, indem sie aus den Behavior-Aggregaten die Treffer-Mengen-Asymmetrie berechnet und einen Vorschlag macht. Wenn die Klick-Verteilung für "Pulli" eine deutliche Konzentration auf eine Sub-Kategorie zeigt und die Klick-Verteilung für "Pullover" über alle Sub-Kategorien streut, ist die Asymmetrie evident. Der Editorial-Vorschlag berücksichtigt diese Asymmetrie und schlägt eine uni-direktionale Konfiguration vor.
Die Pflege-Disziplin braucht ein Eingangs-Schema, das die Richtung explizit verlangt. In einer integrierten Such-Architektur ist dieses Schema im Editorial-Backend kodiert. In einer Tabelle ohne strukturelle Disziplin wird die Richtung in der Eile übergangen, und die Such-Logik fällt auf eine Standard-Bidirektionalität zurück, die strukturell unscharfe Ergebnisse produziert.
Manuelle Kontrolle als Sicherheitsnetz: warum AI-Vorschläge nicht Auto-Deploy sind
Kann ich AI-Vorschläge mit hoher Konfidenz nicht einfach automatisch freischalten?
Eine Versuchung beim AI-gestützten Synonym-Management ist die Auto-Approval. Wenn der Vorschlag-Algorithmus eine hohe Konfidenz hat, könnte das System den Vorschlag direkt live setzen, ohne Editorial-Intervention. Diese Versuchung ist gefährlich.
Drei Risiken machen den Auto-Deploy-Pfad strukturell ungeeignet. Erstes Risiko: False-Positive-Synonyme. Ein hochkorrelierter Klick-Pattern zwischen zwei Such-Termen muss nicht bedeuten, dass die Terme synonym sind. Sie können auch Komplementär-Produkte sein, die im selben Kauf-Kontext gesucht werden. Wer "Drucker" und "Tinte" als Synonyme deployt, weil die Klick-Pattern korrelieren, mischt zwei unterschiedliche Sortiments-Bereiche und erzeugt eine unscharfe Treffer-Liste.
Zweites Risiko: konnotative Differenzen. Ein semantisch ähnliches Wort kann eine andere Konnotation tragen. "Billig" und "günstig" sind im technischen Sinn Synonyme, aber im Shop-Kontext sind sie nicht austauschbar. "Günstige Produkte" ist eine positive Such-Absicht, "billige Produkte" hat eine abwertende Komponente. Wer beide Begriffe synonymisiert, könnte das Sortiment auf eine niedrigpreisige Sub-Klasse fokussieren, die der "günstige Produkte"-Sucher gar nicht wollte.
Drittes Risiko: Brand-Sicherheit. Manche Marken-Synonyme sind rechtlich heikel. Ein Shop, der nicht-autorisierte Marken-Synonyme aktiviert, kann Marken-Rechte-Probleme bekommen. Auto-Deploy würde dieses Risiko in die Pipeline einbauen und das Team aus der Verantwortungs-Kette entfernen. Editorial-Approval ist hier nicht nur eine Qualitäts-Maßnahme, sondern eine Compliance-Schutzschicht.
Die strukturelle Antwort ist ein Editorial-Workflow, in dem AI-Vorschläge als Drafts in einem Backlog landen. Das Team sieht in einem Dashboard die täglich generierten Vorschläge, mit Konfidenz-Wert, mit Evidenz-Beispielen aus dem Search-Log, mit einer semantischen Klassifikation. Das Team approvet, rejectet oder modifiziert den Vorschlag. Erst nach der Approval wird der Synonym-Eintrag live gesetzt. Die Pflege-Hoheit bleibt beim Menschen, die Vorschlag-Generierung läuft maschinell.
Dieser Editorial-Workflow ist die direkte Übersetzung des Auto-Manuell-Hybrids, den wir im Beitrag zum 80:20-Auto-Ranking-Prinzip für das Such-Ranking beschrieben haben. Die Auto-Schicht generiert achtzig Prozent des Vorschlags-Volumens, die manuelle Schicht behält die Hoheit über die zwanzig Prozent, die strategisch oder qualitativ entscheidend sind. Im Synonym-Kontext ist die Auto-Schicht der Vorschlag-Generator, die manuelle Schicht die Editorial-Approval. Die beiden Schichten greifen ineinander, ohne dass eine die andere ersetzt.
"Was uns geholfen hat, war die Sicht auf die Treffer-Listen in Echtzeit. Wir konnten zum ersten Mal sehen, welche Produkte für unsere wichtigsten Such-Anfragen tatsächlich oben standen, und wo unsere Saison-Aktionen liefen, ohne dass wir sie raten mussten. Die Möglichkeit, gezielt einzugreifen ohne den Algorithmus komplett zu ersetzen, hat uns die Steuerung zurückgegeben, ohne die wir vorher operativ eingeschränkt waren."
Solit Group GmbH
Im Edelmetall-Versand ist die Synonym-Pflege besonders sensibel, weil Brand-Namen, Münz-Bezeichnungen und Edelmetall-Termini eng ineinandergreifen. Der Editorial-Workflow hat hier eine zusätzliche Compliance-Bedeutung, weil falsche Synonyme rechtliche Konsequenzen haben können.
Multi-Language: was im Deutschen Synonym ist, ist im Englischen etwas anderes
Reicht für einen mehrsprachigen Shop nicht eine einzige Synonym-Tabelle?
Ein Shop, der in mehreren Sprachen ausliefert, kann nicht eine einzige Synonym-Tabelle für alle Sprachen pflegen. Die Synonym-Klassen sind sprach-spezifisch, und die Übertragung von Synonymen aus einer Sprache in eine andere ist meist nicht eins-zu-eins möglich.
Erstes Problem: lexikalische Lücken. Im Deutschen gibt es "Pullover", "Pulli", "Strick", "Sweater", "Sweatshirt" als überlappende Begriffe. Im Englischen entspricht "Pullover" eher dem Begriff "Jumper" (British) oder "Sweater" (American). Wer die deutsche Synonym-Tabelle direkt ins Englische übersetzt, verfehlt die Konvention der Ziel-Sprache und produziert unscharfe Treffer-Listen.
Zweites Problem: falsche Freunde. Im Deutschen ist "Gift" das Synonym für "Toxin", im Englischen für "Geschenk". Wer eine direkte Übersetzung der Synonym-Tabelle macht, produziert sprach-überschreitende Synonyme, die in der Ziel-Sprache absurde Treffer-Listen erzeugen. Diese falschen Freunde sind ein klassischer Multi-Language-Fehler.
Drittes Problem: regionale Varianten innerhalb derselben Sprache. Britisch-Englisch "Jumper" und Amerikanisch-Englisch "Sweater" sind funktionale Synonyme, aber für einen UK-Shop ist "Jumper" der primäre Term und für einen US-Shop ist es "Sweater". Wer beide Märkte bedient, braucht zwei Synonym-Tabellen oder eine Tabelle mit regionalen Tags.
Die Lösung ist eine sprach-spezifische Pflege pro Land oder Sprach-Bereich, mit einer gemeinsamen Cluster-Schicht für sprachüberschreitende semantische Verbindungen. Wir haben das Multi-Country-Setup im Beitrag zu Multi-Country E-Commerce-Suche im Detail beschrieben. Die Synonym-Tabelle ist Teil der lokalen Konfiguration und teilt sich nicht über die Sprach-Grenze hinweg. Die AI-Vorschlag-Schicht läuft pro Sprache separat, lernt aus den lokalen Search-Logs und schlägt sprach-spezifische Einträge vor.
Diese Trennung hat eine zweite Konsequenz: die Editorial-Hoheit liegt im Idealfall beim lokalen Markt-Team, nicht in einer zentralen Pflege-Stelle. Ein Pflege-Team in München kennt den österreichischen Slang nicht so gut wie ein Team in Wien. Ein Pflege-Team in Berlin kennt das Schweizerdeutsche nicht so gut wie ein Team in Zürich. Eine lokale Editorial-Verantwortung erhöht die Pflege-Qualität, weil die kulturelle Nähe zur Sprach-Realität gegeben ist.
Stop-Words, Akzente und die Grenze zwischen Synonym und Token-Behandlung
Gehören Umlaute und Stop-Words in die Synonym-Tabelle oder woanders hin?
Eine technische Grenze in der Synonym-Pflege ist die Frage, was als Synonym und was als Token-Behandlung verarbeitet wird. Die Antwort hat technische Konsequenzen, weil die beiden Schichten unterschiedlich konfiguriert sind und unterschiedlich performen.
Akzente und Umlaute werden in der Regel nicht als Synonyme gepflegt, sondern in der Token-Normalisierung. Die Such-Anfrage "Möbel" wird intern auf "moebel" normalisiert, und der Index hat beide Repräsentationen. Wer Akzent-Varianten als Synonyme pflegt, macht eine doppelte Arbeit, die in der Token-Schicht effizienter gelöst ist. Diese Token-Normalisierung haben wir im Beitrag zu Tokenseparatoren in der Shop-Suche im Detail behandelt.
Stop-Words werden in der Regel ebenfalls nicht als Synonyme gepflegt, sondern in einer Stop-Word-Liste, die in der Token-Schicht ausgefiltert wird. "Der", "die", "das", "und", "oder" sind keine such-relevanten Terme und werden vor der Synonym-Auflösung entfernt. Wer Stop-Words in die Synonym-Tabelle aufnimmt, vermischt zwei Schichten und erzeugt unkontrollierte Treffer-Listen.
Mehrwort-Stop-Phrasen sind ein Sonderfall. "Ist es" oder "wie viel" sind Mehrwort-Phrasen, die in einer Such-Anfrage selten als Suchabsicht gemeint sind. Wer diese Phrasen filtert, riskiert die Verstümmelung von Such-Anfragen, die diese Wörter als Teil der Produkt-Bezeichnung enthalten. Die Stop-Phrase-Pflege ist ein technisches Detail, das in der Synonym-Diskussion oft mit angesprochen wird, aber strukturell in einer anderen Schicht lebt.
Die Grenze zwischen Synonym und Token-Behandlung ist nicht immer scharf. In der Praxis ist die Faustregel: Wenn die Beziehung morpho-logisch ist (Plural-Singular, Akzent-Varianten, Groß-Klein-Schreibung), gehört sie in die Token-Normalisierung. Wenn die Beziehung semantisch ist (Marken-Synonym, Produkt-Typ-Synonym, Tippfehler), gehört sie in die Synonym-Tabelle. Wer diese Grenze sauber zieht, hat eine effiziente Pflege-Architektur. Wer sie verschwimmen lässt, baut Doppel-Pflege und Performance-Probleme ein.
AB-Test-Disziplin: jeden Synonym-Eintrag messbar machen
Woher weiß ich, ob ein Synonym-Eintrag die Conversion wirklich hebt?
Die AI-Vorschläge sind nur dann nachhaltig wirksam, wenn sie kontinuierlich gemessen werden. Ein Synonym-Eintrag, der live gesetzt wird, kann theoretisch die Conversion heben. Er kann sie praktisch senken, wenn er die Treffer-Liste verwässert oder eine ungewollte Sortiments-Verschiebung produziert. Ohne Messung ist die Pflege eine Hypothese, mit Messung ist sie eine Evidenz-basierte Disziplin.
Die saubere Messung läuft pro Synonym-Eintrag in einem A/B-Test-Schema. Ein Anteil der Sessions sieht die Such-Anfrage mit dem aktivierten Synonym, ein Anteil sieht sie ohne. Die Klick-Verteilung, die Add-to-Cart-Rate und die Conversion-Rate werden pro Variante getrennt erfasst. Nach einer ausreichenden Daten-Phase (typisch eine bis vier Wochen, abhängig vom Such-Volumen) wird die Variante mit der besseren Performance permanent live gesetzt, die andere wird entfernt.
In der Praxis ist diese Schema-Disziplin selten, weil sie ein A/B-Test-Framework auf der Synonym-Schicht voraussetzt. Die meisten Shops haben A/B-Tests für Page-Layouts und Promo-Banner, aber nicht für Synonym-Einträge. Die Folge ist ein langsam wachsender Pflege-Bestand, der nie auf seine echte Wirkung getestet wurde. Manche Einträge sind nützlich, manche sind neutral, manche sind schädlich. Ohne Test ist die Verteilung unbekannt.
Eine Mid-Enterprise-Pipeline integriert den A/B-Test als Standard-Element des Editorial-Workflows. Sobald ein Editorial-Approval erfolgt, läuft der Eintrag automatisch in einer Test-Phase, in der die Wirkung gemessen wird. Erst nach erfolgreichem Test geht der Eintrag in den Stamm-Bestand. Diese Disziplin verhindert die Akkumulation von Pflege-Müll und gibt dem Team eine empirische Grundlage für Pflege-Entscheidungen.
Die Erfolgs-Metriken sind die gleichen wie im Hybrid-Ranking-Kontext: NDCG@5 für die Ranking-Qualität, MRR für die Position des ersten gekauften Produkts, Search Revenue per Session als direkte Business-Metrik. Wer diese Metriken pro Synonym-Eintrag erfassen kann, hat eine Pflege-Pipeline, die nicht nur generiert, sondern auch validiert. Wer sie nicht erfassen kann, hat eine Pflege-Pipeline, die im Blindflug arbeitet.
Anti-Pattern: zu aggressive Synonym-Expansion
Ist es nicht besser, pro Suchanfrage möglichst viele Synonyme zu hinterlegen?
Eine der häufigsten Pflege-Fehler ist die zu aggressive Synonym-Expansion. Das Team meint es gut, fügt für jede beobachtete Such-Anfrage drei bis fünf Synonyme hinzu und glaubt, damit die Trefferquote zu heben. In der Praxis senkt diese Expansion die Treffer-Qualität, weil die Treffer-Liste mit semantisch entfernten Produkten verwässert wird.
Der Mechanismus ist subtil. Eine Such-Anfrage "Sommerkleid" mit den Synonymen "Sommermode", "Sommer-Outfit", "leichtes Kleid", "Sommer-Wear" expandiert intern auf fünf Such-Anfragen, deren Treffer-Listen zusammengeführt werden. Ein Produkt, das nur zu "Sommermode" passt, aber nicht zu "Sommerkleid", taucht jetzt in der Treffer-Liste auf. Die Liste wird länger, aber die Relevanz pro Position sinkt.
Das Anti-Pattern lässt sich an einer Metrik erkennen: die NDCG@5-Metrik fällt, obwohl die Anzahl der Treffer steigt. Wer nur die Treffer-Anzahl als Erfolgs-Metrik liest, sieht eine Verbesserung. Wer die NDCG-Metrik liest, sieht die Verwässerung. Die NDCG ist hier die ehrliche Metrik, die Treffer-Anzahl ist die irreführende.
Die strukturelle Gegen-Maßnahme ist eine konservative Pflege-Disziplin. Synonyme werden nur dann angelegt, wenn die semantische Nähe hoch genug ist, dass die Treffer-Klick-Verteilung tatsächlich überlappt. Vorschläge mit niedriger Konfidenz werden im Editorial-Backlog rejected, nicht approvt. Die Pflege-Tabelle ist klein und scharf, nicht groß und unscharf. Diese Disziplin verlangt vom Team eine Selbstbeschränkung, die in der ersten Pflege-Phase oft unbeliebt ist, weil sie nach "weniger tun" aussieht. Sie ist aber strukturell die richtige Pflege-Haltung.
Eine zweite Gegen-Maßnahme ist die semantische Schicht im Hybrid-Ranking, die wir in mehreren Beiträgen behandelt haben. Wenn die semantische Schicht aus einem Sprachmodell die Bedeutungsnähe ohnehin in das Ranking einrechnet, sind viele weiche Synonyme bereits abgedeckt, ohne dass sie in der Tabelle stehen müssen. Die Tabelle kann sich auf die harten Synonyme konzentrieren (Marken, Tippfehler, Akronyme), während die weichen Synonyme (Produkt-Typ-Nähe, Konnotation) in der semantischen Schicht laufen. Diese Arbeitsteilung verkleinert die Pflege-Tabelle und erhöht die Ranking-Qualität.
Wie Hybrid-LLM-Search die Synonym-Pflege verändert
Ändert eine Hybrid-LLM-Schicht überhaupt etwas an meiner Synonym-Pflege?
Die Einführung einer Hybrid-LLM-Schicht in der Such-Architektur verändert die Synonym-Pflege strukturell. Ein Sprachmodell versteht semantische Nähe direkt aus dem Embedding-Raum, ohne dass die Nähe als Tabellen-Eintrag kodiert sein muss. Eine Anfrage "Sweatshirt" findet das Produkt "Hoodie" auch dann, wenn kein Synonym-Eintrag existiert, weil die Embedding-Distanz zwischen den beiden Begriffen klein ist.
Diese semantische Schicht ersetzt einen Teil der traditionellen Synonym-Pflege. Produkt-Typ-Synonyme, die in der lexikalischen Welt eine eigene Pflege brauchten, sind in der semantischen Schicht implizit abgedeckt. Konnotative Verwandtschaften, die als Synonym schwer zu fassen waren, werden im Embedding-Raum als nahe Punkte abgebildet. Die Tabelle wird kleiner, die semantische Schicht übernimmt die weichen Beziehungen.
Was die semantische Schicht nicht abdeckt, sind die deterministischen Synonyme. Marken-Synonyme sind eine bewusste Entscheidung des Shops und können nicht aus einem allgemeinen Sprachmodell abgeleitet werden. Tippfehler-Synonyme sind keine semantische Nähe, sondern eine orthografische Korrektur. Akronym-Vollwort-Paare sind sprach-spezifische Konventionen, die in einem allgemeinen Embedding nicht zuverlässig kodiert sind. Diese drei Klassen bleiben in der Synonym-Tabelle.
Die strukturelle Konsequenz ist eine Aufteilung der Pflege. Die semantische Schicht arbeitet automatisch und braucht keine manuelle Konfiguration. Die Synonym-Tabelle arbeitet manuell und konzentriert sich auf die Klassen, die strukturell deterministisch sind. Die AI-Vorschlag-Schicht arbeitet semi-automatisch und füllt die Tabelle mit Vorschlägen, die das Team approvet oder rejected. Die drei Schichten greifen ineinander, ohne dass eine die andere ersetzt.
In der Praxis bedeutet das: Wer eine Hybrid-LLM-Schicht hat, kann seine Synonym-Tabelle auf ein Bruchteil der bisherigen Größe schrumpfen, ohne dass die Treffer-Qualität leidet. Die Pflege-Last sinkt, die Treffer-Qualität bleibt oder steigt. Wer die Hybrid-LLM-Schicht nicht hat, ist auf eine ausgewachsene Synonym-Tabelle angewiesen und trägt den entsprechenden Pflege-Aufwand.
"Mit BatteryIncluded haben wir endlich ein Werkzeug, das unsere Markenwelt versteht. Unsere Kundinnen und Kunden finden ihre Produkte schneller, was sich direkt in der Conversion zeigt. Was uns besonders überzeugt hat, ist die Möglichkeit, unsere eigene Markensprache abzubilden, ohne dass wir auf eine Standard-Vorgabe reduziert werden."
G. Wurm GmbH + Co. KG
Im Bastelbedarf-Sortiment ist die Markensprache besonders eigen. Werkstoff-Begriffe, Werkzeug-Bezeichnungen und Kreativ-Slang verlangen eine sprachliche Pflege, die nicht aus einem Standard-Sprachmodell ableitbar ist. Die Synonym-Tabelle ist hier der Ort, an dem die Marken-Identität in das Such-System übersetzt wird, und die AI-Vorschläge sind die Beobachtung der Sprach-Realität in den Search-Logs.
Editorial-Workflow: wer entscheidet welche AI-Vorschläge live gehen
Wer im Team sollte entscheiden, welche AI-Vorschläge live gehen?
Die Editorial-Disziplin ist der Knackpunkt jeder Synonym-Pflege. Wer entscheidet, welche AI-Vorschläge in die Live-Tabelle übernommen werden, mit welcher Geschwindigkeit, mit welchen Eskalations-Pfaden? Diese Fragen sind organisatorisch, nicht technisch, aber sie bestimmen die Pflege-Qualität mehr als jede Technik.
Ein praxis-tauglicher Editorial-Workflow hat drei Ebenen. Erste Ebene: ein operativer Editor, der täglich die AI-Vorschläge durchgeht, offensichtliche Approvals und Rejections vornimmt und die unklaren Fälle in eine zweite Eskalations-Ebene weiterreicht. Diese Rolle braucht etwa eine halbe Stunde pro Tag bei einem Mid-Enterprise-Shop und ist typisch im Marketing oder Customer-Care angesiedelt.
Zweite Ebene: ein Senior-Editor, der die unklaren Fälle wöchentlich review, die strategischen Synonym-Entscheidungen trifft und die Pflege-Tabelle gegen die Sortiments-Strategie abgleicht. Diese Rolle braucht etwa zwei Stunden pro Woche und ist typisch im SEO oder Brand-Management angesiedelt.
Dritte Ebene: ein monatliches Audit, in dem die Pflege-Tabelle gegen die Performance-Daten geprüft wird. Welche Einträge haben in den letzten dreißig Tagen positive Conversion-Wirkung gezeigt, welche neutrale, welche negative? Negative Einträge werden entfernt oder modifiziert. Diese Audit-Rolle braucht etwa einen halben Tag pro Monat und ist die Qualitäts-Sicherung der Pflege-Pipeline.
Die drei Ebenen sind nicht alle in einer Person bündelbar, aber sie sind in einem mittelgroßen Team mit drei bis fünf Marketing-Köpfen gut verteilbar. Wichtig ist die Klarheit, wer was entscheidet. Wenn die Verantwortung diffus ist, läuft der Editorial-Workflow leer, die AI-Vorschläge akkumulieren ungelesen, die Pflege-Tabelle veraltet. Die Klarheit der Rollen ist die strukturelle Voraussetzung dafür, dass die AI-Vorschlag-Schicht ihre Wirkung entfaltet.
Eine technische Unterstützung ist das Editorial-Dashboard, das die Vorschläge nach Konfidenz sortiert, die Evidenz-Beispiele aus den Search-Logs anzeigt und die Approval-Aktionen mit einem Klick ermöglicht. Ohne dieses Dashboard ist die Editorial-Arbeit ein Excel-Spiel, das den Pflege-Aufwand zu hoch macht. Mit dem Dashboard ist es eine wöchentliche Routine, die in das Marketing-Standard-Setup passt.
Was Sie diese Woche tun können
Womit fange ich diese Woche konkret an, wenn meine Pflege noch rein manuell läuft?
Wenn Sie heute eine Shop-Suche betreiben, deren Synonym-Pflege rein manuell und ohne AI-Unterstützung läuft, ist der pragmatische Einstieg in fünf Schritten.
Schritt eins ist die Pflege-Tabellen-Inventur. Exportieren Sie die aktuelle Synonym-Tabelle und prüfen Sie sie in drei Schichten. Welche Einträge sind heiß und werden in den Such-Logs regelmäßig getroffen? Welche sind alt und wurden seit zwölf Monaten nicht aktualisiert? Welche fehlen, weil sie in den Null-Treffer-Logs auftauchen? Die Inventur ist die Grundlage für die Pflege-Neu-Aufsetzung. Sie braucht typisch einen halben Tag.
Schritt zwei ist die Search-Log-Analyse. Aktivieren Sie die GA4-View-Search-Results-Events, falls sie nicht aktiv sind, und extrahieren Sie die Top-Null-Treffer-Suchen der letzten dreißig Tage. Die Liste ist die direkte Quelle für die ersten manuell gepflegten Synonyme. Wer die GA4-Implementierung sauber hat, kann diesen Schritt aus dem BigQuery-Export ableiten. Die Mechanik haben wir im Beitrag zu GA4-Transaktionsdaten als Such-Signal im Detail behandelt.
Schritt drei ist die Klassen-Unterscheidung. Sortieren Sie die existierenden Einträge in die sechs Klassen, die wir oben beschrieben haben: Marken-Synonyme, Produkt-Typ-Synonyme, Tippfehler-Synonyme, Akronyme, Regionalismen, Mehrwort-Synonyme. Jede Klasse bekommt eine eigene Pflege-Disziplin und eine eigene Richtungs-Voreinstellung. Diese Klassen-Logik ist die Voraussetzung für eine strukturierte Pflege, die nicht in einer Tabellen-Säule verschwimmt.
Schritt vier ist die Richtungs-Audit. Prüfen Sie pro Eintrag, ob die Richtung (bi-direktional oder uni-direktional) korrekt gesetzt ist. Die meisten existierenden Synonym-Tabellen haben hier strukturelle Fehler, weil die Richtung in der Pflege-Eile übersprungen wurde. Wer die Richtung sauber setzt, hat in vielen Fällen schon eine spürbare Verbesserung der Treffer-Qualität, ohne neue Einträge anzulegen.
Schritt fünf ist die Editorial-Workflow-Definition. Klären Sie, wer in Ihrem Team die operative Approval-Rolle übernimmt, wer die strategische Senior-Editor-Rolle, wer das monatliche Audit. Wenn die Rollen klar verteilt sind, kann die AI-Vorschlag-Schicht ihre Wirkung entfalten. Wenn sie diffus sind, läuft jede AI-Unterstützung leer. Diese Rollen-Klärung ist nicht technisch, aber sie ist die organisatorische Grundlage der gesamten Pflege-Architektur.
Diese fünf Schritte sind unabhängig davon sinnvoll, ob Sie auf eine spezialisierte AI-Such-Infrastruktur wechseln oder eine bestehende Lösung erweitern. Was sie nicht ersetzen können, ist die operative Reife einer Plattform, die die AI-Vorschlag-Generierung, das Editorial-Dashboard, den A/B-Test-Workflow und die Hybrid-LLM-Integration aus einer Hand mitbringt. Eine vertiefte Behandlung der Synonym-Klassen pro Sortiments-Typ werden wir in einem späteren Beitrag dieser Serie behandeln.
"BatteryIncluded.ai ist genau das, was man sich von moderner E-Commerce-Technologie wünscht: blitzschnelle Suche auch bei über 50.000 Produkten, volle Anpassbarkeit für komplexe Anforderungen, und ein Support, der nicht nur reagiert, sondern wirklich versteht. Stabil, skalierbar, zukunftssicher."
Österreichischer Bundesverlag Schulbuch GmbH & Co. KG
Im B2B-Schulbuch-Versand mit grossem Sortiment und Fach-Vokabular ist die Synonym-Pflege ein Dauer-Thema. Lehrplan-Begriffe, Schul-Slang und Verlags-Bezeichnungen leben in einer Sprach-Welt, die nur durch eine konsequente Pflege in der Such-Trefferquote abgebildet wird. Die AI-Vorschlag-Schicht ist hier nicht ein Komfort-Feature, sondern eine strukturelle Voraussetzung dafür, dass das Pflege-Team mit dem Sortiments-Wachstum mithalten kann.
Häufige Fragen (FAQ)
Was sind die wichtigsten Synonym-Klassen in einer Shop-Suche?
Sechs Klassen decken den größten Teil der real auftretenden Synonym-Bedarfe ab. Marken-Synonyme (Apple und Mac) sind meist bi-direktional und strategisch wichtig. Produkt-Typ-Synonyme (Pulli und Pullover) sind bi-direktional, aber mit Klassen-Differenzierung zu pflegen. Tippfehler-Synonyme (Saugmöp und Saugmop) sind die zahlenmäßig größte Klasse und überschneiden sich mit der Fehlertoleranz-Schicht. Akronyme (ASS und Acetylsalicylsäure) sind meist uni-direktional. Regionalismen (Brötchen und Semmel) sind regional differenziert und brauchen sprach-spezifische Pflege. Mehrwort-Synonyme (kabelloses Ladegerät und Wireless Charger) sind technisch anspruchsvoll und brauchen eine Token-Strategie. Jede Klasse hat eine eigene Pflege-Logik und sollte in der Tabelle strukturell unterscheidbar sein.
Wie funktioniert die Auto-Discovery von Synonym-Vorschlägen aus Search-Logs?
Drei Muster in der Search-Log-Analyse liefern den größten Vorschlag-Wert. Erstens, Null-Treffer-Suchen mit anschließender Erfolgssuche im selben Session-Verlauf zeigen direkt ein Synonym-Paar an. Zweitens, parallele Such-Treffer-Konvergenz: wenn zwei verschiedene Such-Terme statistisch zu Klicks auf dieselbe Treffer-Menge führen, ist das ein Synonym-Signal. Drittens, aufeinanderfolgende Sessions mit unterschiedlichen Such-Termen und unterschiedlichen Klick-Raten zeigen eine Such-Re-Formulierung an, die zu einem Mehrwort-Synonym führen kann. Die drei Muster werden in einem Scoring-Schema kombiniert, und nur Vorschläge oberhalb einer Konfidenz-Schwelle landen im Editorial-Backlog. Die Search-Log-Analyse läuft auf der gleichen Cookieless-Cohort-Aggregation, die auch das Behavior-Lernen für das Ranking versorgt.
Sollten AI-Vorschläge automatisch deployed werden?
Nein. Drei Risiken machen den Auto-Deploy-Pfad strukturell ungeeignet. Erstens, False-Positive-Synonyme: hochkorrelierte Klick-Pattern bedeuten nicht zwangsläufig semantische Synonymität. Zweitens, konnotative Differenzen: semantisch ähnliche Wörter können unterschiedliche Konnotationen tragen (zum Beispiel "billig" und "günstig"). Drittens, Brand-Sicherheit: manche Marken-Synonyme sind rechtlich heikel und brauchen eine bewusste Approval-Entscheidung. Die strukturelle Antwort ist ein Editorial-Workflow, in dem AI-Vorschläge als Drafts in einem Backlog landen und vom Team approved, rejected oder modifiziert werden. Die Pflege-Hoheit bleibt beim Menschen, die Vorschlag-Generierung läuft maschinell.
Wann ist ein Synonym bi-direktional und wann uni-direktional?
Marken-Synonyme sind in der Regel bi-direktional, weil die Begriffe austauschbar sind. Akronym-Vollwort-Paare sind in der Regel uni-direktional, weil das Vollwort spezifischer ist als das Akronym. Tippfehler-Synonyme sind in der Regel uni-direktional, weil der korrekte Term das Ziel der Korrektur ist. Produkt-Typ-Synonyme sind oft bi-direktional, brauchen aber eine Klassen-Differenzierung, weil zum Beispiel "Pulli" ein Slang-Term für eine Sub-Klasse von "Pullover" sein kann. Eine ML-Schicht kann aus den Behavior-Aggregaten die Treffer-Mengen-Asymmetrie berechnen und einen Vorschlag für die richtige Richtung machen. In der Pflege-Eile wird die Richtung oft falsch gesetzt, und die Such-Logik fällt auf eine Standard-Bidirektionalität zurück, die unscharfe Ergebnisse produziert.
Wie geht die Synonym-Pflege mit mehreren Sprachen um?
Eine Synonym-Tabelle ist sprach-spezifisch und kann nicht eins-zu-eins zwischen Sprachen übersetzt werden. Drei Probleme sind typisch: lexikalische Lücken (im Deutschen gibt es überlappende Begriffe, die im Englischen keine Entsprechung haben), falsche Freunde (im Deutschen "Gift" als Toxin, im Englischen als Geschenk), und regionale Varianten innerhalb derselben Sprache (britisch "Jumper", amerikanisch "Sweater"). Die Lösung ist eine sprach-spezifische Pflege pro Land oder Sprach-Bereich, mit einer AI-Vorschlag-Schicht, die pro Sprache separat aus den lokalen Search-Logs lernt. Die Editorial-Hoheit liegt im Idealfall beim lokalen Markt-Team, weil die kulturelle Nähe zur Sprach-Realität die Pflege-Qualität erhöht.
Wo liegt die Grenze zwischen Synonym-Pflege und Token-Normalisierung?
Wenn die Beziehung morpho-logisch ist (Plural-Singular, Akzent-Varianten, Groß-Klein-Schreibung), gehört sie in die Token-Normalisierung. Akzente und Umlaute werden in der Regel intern normalisiert, sodass "Möbel" und "moebel" beide gefunden werden, ohne dass ein Synonym-Eintrag nötig ist. Stop-Words werden in einer Stop-Word-Liste ausgefiltert, nicht in der Synonym-Tabelle gepflegt. Wenn die Beziehung semantisch ist (Marken-Synonym, Produkt-Typ-Synonym, Tippfehler), gehört sie in die Synonym-Tabelle. Wer diese Grenze sauber zieht, hat eine effiziente Pflege-Architektur ohne Doppel-Pflege und ohne Performance-Probleme.
Verändert eine Hybrid-LLM-Schicht die Synonym-Pflege?
Ja, strukturell. Ein Sprachmodell versteht semantische Nähe direkt aus dem Embedding-Raum, ohne dass die Nähe als Tabellen-Eintrag kodiert sein muss. Produkt-Typ-Synonyme, die in der lexikalischen Welt eine eigene Pflege brauchten, sind in der semantischen Schicht implizit abgedeckt. Was die semantische Schicht nicht abdeckt, sind die deterministischen Synonyme: Marken-Synonyme sind eine bewusste Entscheidung des Shops, Tippfehler-Synonyme sind orthografische Korrekturen, Akronym-Vollwort-Paare sind sprach-spezifische Konventionen. Wer eine Hybrid-LLM-Schicht hat, kann seine Synonym-Tabelle auf einen Bruchteil der bisherigen Größe schrumpfen und sich auf die deterministischen Klassen konzentrieren. Die Pflege-Last sinkt, die Treffer-Qualität bleibt oder steigt.
Wie wird die Wirkung einzelner Synonym-Einträge gemessen?
In einem A/B-Test-Schema pro Eintrag. Ein Anteil der Sessions sieht die Such-Anfrage mit dem aktivierten Synonym, ein Anteil sieht sie ohne. Die Klick-Verteilung, die Add-to-Cart-Rate und die Conversion-Rate werden pro Variante getrennt erfasst. Nach einer Daten-Phase von einer bis vier Wochen wird die Variante mit der besseren Performance live gesetzt. Die Erfolgs-Metriken sind die gleichen wie im Hybrid-Ranking-Kontext: NDCG@5 für die Ranking-Qualität, MRR für die Position des ersten gekauften Produkts, Search Revenue per Session als direkte Business-Metrik. Wer diese Metriken pro Synonym-Eintrag erfassen kann, vermeidet die Akkumulation von Pflege-Müll und gibt dem Team eine empirische Grundlage für Pflege-Entscheidungen.
Bereit für eine Synonym-Pflege, die nicht im Excel-Chaos endet?
Die Synonym-Tabelle in Ihrem Shop ist heute die Stelle, an der Marketing-Pflege, Editorial-Disziplin und technische Such-Konfiguration zusammenlaufen. Sie ist gleichzeitig der Punkt, an dem manuelle Pflege strukturell überfordert ist, sobald das Sortiment, die Suchanfragen oder die Marken-Welt eine bestimmte Größe übersteigen. Volt Search® und AI Recommendations von BatteryIncluded sind als entkoppelte Infrastruktur konzipiert, in der die manuelle Synonym-Tabelle, die AI-Vorschlag-Pipeline aus Search-Logs, der Editorial-Workflow für Approval und Rejection und der A/B-Test-Mechanismus für jede Pflege-Änderung nativ zusammenlaufen. Cookieless, DSGVO-konform, Made in Germany, ohne dass Sie eine eigene Search-Log-Analyse engineering oder einen separaten Editorial-Stack betreiben müssen.
Synonyme-Pflege mit AI-Vorschlägen live sehen und erleben Sie an Ihren eigenen Such-Logs, wie aus dem täglichen Strom von Null-Treffer-Suchen und Re-Formulierungen ein Editorial-Backlog wird, der das Team mit konkreten Pflege-Vorschlägen versorgt, ohne dass die manuelle Hoheit verloren geht. Wie die Hybrid-LLM-Schicht die weichen Synonyme automatisch abdeckt und die manuelle Pflege auf die deterministischen Klassen konzentriert. Wie der Editorial-Workflow die Approval-Entscheidung in eine wöchentliche Routine überführt, statt in ein Excel-Drama, das Quartal für Quartal weiter wuchert.
