
GA4 Transaktionsdaten als Such-Signal: Klicks, Warenkörbe, Käufe als Ranking-Trainer
Die GA4-Daten in Ihrem Shop sind heute schon da. Was fehlt, ist die Pipeline, die Klicks, Warenkörbe und Käufe als kontinuierlichen Trainings-Strom in das Such-Ranking zurückspielt. Wie GA4-Events, Cohort-Aggregation, Cold-Start-Lösungen für Long-Tail-Queries, Anti-Lock-in-Mechaniken und A/B-Test-Disziplin zusammen ein Ranking ergeben, das aus jeder Such-Session lernt.
Der Datenstrom, der ungenutzt liegen bleibt
Viele E-Commerce-Manager fragen sich: Warum fließen die GA4-Signale aus Klicks, Warenkörben und Käufen nicht ins Such-Ranking zurück? Weil GA4-Daten meist in der Reporting-Kette landen und die Such-Lösung in der Engineering-Kette – beide Ketten kennen sich nicht, und so bleibt das Ranking auf dem Stand der Produkt-Pflege eingefroren. Wie sich diese Lücke schließen lässt, zeigt dieser Artikel Schicht für Schicht.
Ein mittelgroßer Mode-Shop in Süddeutschland, Donnerstagvormittag, das Marketing-Team sitzt im wöchentlichen Performance-Termin. Auf dem Bildschirm läuft das GA4-Dashboard, die Such-Funnel-Sicht ist offen. In den letzten dreißig Tagen wurden in der Shop-Suche etwa hundertvierzigtausend Suchanfragen gestellt. Die Hälfte davon hat zu einem Produkt-Klick geführt, achtzehn Prozent zu einem Warenkorb-Eintrag, knapp sechs Prozent zu einem tatsächlichen Kauf. Pro Suchterm liegen Klick-Verteilung, Add-to-Cart-Rate und Conversion-Rate auf zweistelliger Granularität vor. Die Daten sind sauber, sie sind aktuell, sie sind über BigQuery exportiert und im Warehouse verfügbar.
Was die Such-Engine im gleichen Shop davon weiß: nichts. Sie liefert die Treffer-Reihenfolge auf Basis des Produkt-Textes, der Tokenisierung und einer BM25-Gewichtung. Die hundertvierzigtausend Such-Sessions, die täglich zeigen, welches Produkt für welche Anfrage tatsächlich konvertiert, fließen nicht in das Ranking zurück. Sie landen im Marketing-Dashboard, werden quartalsweise in einer Powerpoint zusammengefasst und liegen dann im Quartals-Archiv. Die Such-Engine arbeitet weiter, als gäbe es diesen Datenstrom nicht.
Diese Lücke ist nicht ungewöhnlich. Sie ist der Standard-Zustand in praktisch jedem mittelgroßen DACH-Shop, der eine GA4-Implementierung hat und eine separate Such-Lösung betreibt. Die GA4-Daten wandern in die Reporting-Kette, die Such-Lösung wandert in die Engineering-Kette. Beide Ketten kennen sich nicht. Das Ranking bleibt auf den Stand der Produkt-Pflege eingefroren, obwohl jede Woche eine neue Welle an Transaktions-Signalen ins Warehouse rollt.
Wir haben im Beitrag zu Textscore und smarten Listings die Grundsatz-Frage beschrieben, warum BM25 allein in der E-Commerce-Praxis zu kurz greift und welche Rolle GA4-Signale im Hybrid-Ranking spielen. Dieser Artikel ist die Tiefen-Bohrung in das, was dort die Forward-Reference offen gelassen hat. Wie genau wird ein GA4-Event-Stream in einen Trainings-Signal-Strom für das Such-Ranking überführt? Welche Events zählen wirklich, wie werden sie gewichtet, wie wird die Aggregation DSGVO-konform gestaltet, wie geht man mit Cold-Start auf Long-Tail-Queries um, wie verhindert man Lock-in-Effekte durch Klick-Konzentration und wie verbindet sich die Pipeline mit dem Search-Index in Echtzeit oder Nahe-Echtzeit. Diese Fragen sind nicht trivial. Sie sind das Engineering, das hinter einem Ranking steht, das nicht nur match, sondern tatsächlich auf Conversion lernt.
Recap aus Textscore und smarte Listings: warum dieser Artikel den Faden weiterspinnt
Warum reicht die klassische BM25-Logik in einer E-Commerce-Suche nicht aus?
Der frühere Beitrag hat die Grundsatz-Frage gestellt, ob die klassische BM25-Logik in einer E-Commerce-Suche ausreicht. Die Antwort war strukturell verneinend. BM25 berechnet einen Relevanz-Score aus der Verteilung der Suchwörter im Produkt-Text, gewichtet seltene Begriffe stärker als häufige und normalisiert die Dokumentlänge. Was BM25 nicht weiß, ist welches Produkt für eine Anfrage tatsächlich gekauft wird, welche Klickrate eine bestimmte Position erzeugt und welche Conversion-Realität hinter den Treffer-Listen steht. Diese Lücke war die Pain-Diagnose des früheren Beitrags.
Die strukturelle Antwort in jenem Artikel war ein drei- oder vierschichtiges Hybrid-Ranking aus Text-Score, Behavior-Score, semantischer Schicht und optional Verfügbarkeits-Schicht. Die GA4-Schicht wurde dort als zweite Signal-Schicht eingeführt, mit einer Gewichtungs-Empfehlung zwischen dreißig und vierzig Prozent. Sieben relevante Events wurden benannt, das Cold-Start-Problem wurde skizziert, die Cookieless-Aggregation wurde als DSGVO-konformes Verfahren positioniert.
Was offen blieb, war die Pipeline-Architektur dahinter. Wie wird der Event-Stream eingelesen? Welche Aggregations-Granularität ist die richtige? Wie wird der Behavior-Score in den Index zurückgespielt? Wie geht die Pipeline mit Long-Tail-Queries um, die einzeln zu wenig Daten haben, um statistisch signifikant zu sein? Wie schützt man die ML-Schicht vor Lock-in-Effekten, in denen das oberste Produkt durch seine eigene Position immer mehr Klicks bekommt und damit immer höher gerankt wird? Diese Fragen sind die Operations-Schicht hinter dem Hybrid-Score. Ohne sie ist die Hybrid-Architektur eine Folie, mit ihr ist sie ein laufendes System.
Der vorliegende Artikel ist die Operations-Schicht. Er geht davon aus, dass der Grundsatz aus dem früheren Beitrag verstanden ist, und beschäftigt sich ausschließlich mit der Frage, wie der GA4-Datenstrom konkret zur Trainings-Quelle für das Ranking wird. Wer den früheren Beitrag noch nicht gelesen hat, findet dort die übergeordnete Positionierung des Hybrid-Ranking-Konzeptes, in das dieser Tiefen-Bohrer eingebettet ist.
Die sieben GA4-Events, die wirklich zählen
Wie viele Events wirft eine GA4-Implementierung überhaupt pro Tag aus?
Eine moderne GA4-Implementierung in einem Shop produziert pro Tag mehrere zehntausend bis hunderttausend Events. Für das Such-Ranking sind nicht alle relevant. Sieben Event-Typen tragen das gesamte Trainings-Signal.
Erster Event: view_search_results. Dieser Event wird ausgelöst, wenn ein Kunde eine Such-Anfrage stellt und die Trefferseite gerendert wird. Er enthält den Suchterm, die Anzahl der Treffer und in einer sauberen Implementierung auch die ersten zehn oder zwanzig Produkte in der Treffer-Reihenfolge. Dieser Event ist die Wurzel jedes Trainings-Signals, weil er die Anfrage und die ausgespielte Treffer-Liste verbindet.
Zweiter Event: select_item. Dieser Event wird ausgelöst, wenn der Kunde aus einer Liste heraus auf ein Produkt klickt, in der Regel aus der Suchergebnisseite oder einer Kategorie-Liste. Mit dem item_id und der item_list_name lässt sich der Klick eindeutig der Such-Session und der Treffer-Position zuordnen. Dieser Event liefert das primäre CTR-Signal pro Suchterm und Produkt.
Dritter Event: add_to_cart. Dieser Event wird ausgelöst, wenn ein Produkt in den Warenkorb gelegt wird. Er ist deutlich stärker als select_item, weil er eine konkrete Kaufabsicht ausdrückt. Wenn die Implementierung den Such-Kontext mitführt (über die items_list_id oder eine Session-Variable), lässt sich der Add-to-Cart der ursprünglichen Such-Anfrage zuordnen.
Vierter Event: begin_checkout. Dieser Event ist der Übergang vom Warenkorb in den Checkout-Prozess. Er trennt die explorative Phase von der entschiedenen Phase und ist ein noch stärkeres Signal als add_to_cart, weil viele Warenkörbe nie in den Checkout führen, während die meisten Checkout-Starts eine echte Kauf-Absicht zeigen.
Fünfter Event: purchase. Dieser Event ist das härteste Signal in der gesamten Kette. Er sagt, welche Produkte tatsächlich gekauft wurden, mit welchem Wert und in welcher Kombination. Wer ein Produkt aus einer Such-Anfrage heraus kauft, gibt die stärkste mögliche Bestätigung der Treffer-Qualität.
Sechster Event: view_item. Dieser Event wird auf der Produkt-Detail-Seite ausgelöst und ergänzt select_item um eine Verifikation, dass die PDP tatsächlich geöffnet wurde. In der Praxis ist die Lücke zwischen select_item und view_item gering, aber sie ist als Konsistenz-Check nützlich.
Siebter Event: search. Dieser Event ist der GA4-eigene Tracker für die Such-Anfrage selbst, oft synonym oder redundant mit view_search_results, aber in einigen Implementierungen mit zusätzlichen Parametern wie Filter-Werten oder Sortier-Reihenfolge.
Die sieben Events sind die Rohstoffe. Aus ihnen wird der Trainings-Stream gefertigt. In der Praxis sind drei davon die Hauptlast-Träger: view_search_results, select_item und purchase. Die übrigen vier sind Verfeinerungs-Schichten, die je nach Daten-Volumen unterschiedlich stark einfließen.
Aggregations-Ebene: Cohort statt User
Welche Design-Entscheidung entscheidet in der GA4-Pipeline über Datenschutz und Ergebnis?
Eine zentrale Design-Entscheidung in der GA4-Pipeline ist die Aggregations-Ebene. Wer auf User-Ebene aggregiert, baut Profile auf, ist Tracking-pflichtig und braucht Consent. Wer auf Cohort-Ebene aggregiert, hat keine personenbezogenen Daten und braucht keinen Consent. Die Differenz ist nicht technisch, sondern juristisch und ethisch entscheidend.
Cohort-Aggregation heißt: pro Suchterm und Produkt werden die Events aller Sessions summiert. Für die Anfrage "Sommerkleid blau" liegt eine Tabelle vor, in der für jedes ausgespielte Produkt die Klick-Anzahl, die Add-to-Cart-Anzahl und die Kauf-Anzahl steht. Diese Tabelle enthält keine User-IDs, keine Session-IDs, keine personenbezogenen Merkmale. Sie ist die statistische Verteilung der Such-Antworten pro Suchterm.
Diese Aggregations-Form hat drei Vorteile. Erstens, sie ist DSGVO-konform, weil sie keine personenbezogenen Daten verarbeitet. Sie braucht keinen Cookie-Consent, weil sie die Server-Side-Events anonym aggregiert. Sie erfüllt die Anforderungen der europäischen Datenschutz-Aufsicht ohne zusätzliche Maßnahmen. Zweitens, sie skaliert horizontal, weil die Aggregation pro Suchterm unabhängig läuft und in einer Batch-Pipeline parallelisiert werden kann. Drittens, sie schützt vor Klick-Manipulation durch einzelne Sessions, weil ein einzelner User keinen messbaren Einfluss auf die Aggregat-Statistik einer Anfrage mit hunderten oder tausenden Sessions hat.
Die Cohort-Ebene hat auch Grenzen. Sie kann keine personalisierten Rankings produzieren, weil sie die individuellen Präferenzen einzelner User nicht kennt. Wer auf personalisiertes Ranking setzen will, muss die User-Aggregation wieder einführen und die rechtlichen Konsequenzen tragen. In der DACH-Region ist diese Konsequenz für die meisten Mittelstands-Shops zu groß, sowohl in der Compliance-Last als auch in der Customer-Communication. Die Cohort-Aggregation ist der Mittelweg, der die Sales-Wirkung der Behavior-Signale erschließt, ohne den Datenschutz-Trade-off einzugehen.
Die technische Umsetzung ist unkompliziert. Die GA4-Events werden über BigQuery oder einen Server-Side-Tag-Manager in ein Daten-Warehouse exportiert. Eine SQL-Query aggregiert pro Suchterm und Produkt die Klicks, Add-to-Carts und Käufe. Die Aggregat-Tabelle wird in den Behavior-Index gespielt, der das Such-Ranking modifiziert. User-IDs werden in der Aggregations-Stufe entfernt, bevor die Daten den Daten-Warehouse-Layer verlassen. Diese Trennung ist die technische Grundlage der Cookieless-Aggregation.
Wir haben diese Cookieless-Architektur im Beitrag zur DSGVO-konformen KI Suche ausführlich beschrieben. Sie ist Teil des AI Data Discovery Framework, das BatteryIncluded für alle DACH-Mittelstands-Shops als Standard mitbringt.
Die Score-Hierarchie: Klick, Cart, Checkout, Kauf
Zählt jeder Klick, Warenkorb und Kauf gleich viel fürs Ranking?
Nicht jedes Event hat dasselbe Trainings-Gewicht. Eine reine Klick-Statistik überschätzt die Treffer-Qualität, weil ein Klick auch eine Fehlnavigation oder eine Neugier-Inspektion sein kann. Eine reine Kauf-Statistik ist zu dünn, weil viele Such-Anfragen nicht in den gleichen Tagen in einen Kauf münden. Die Lösung ist eine gewichtete Hierarchie, die die vier Signal-Schichten mit unterschiedlichem Gewicht verarbeitet.
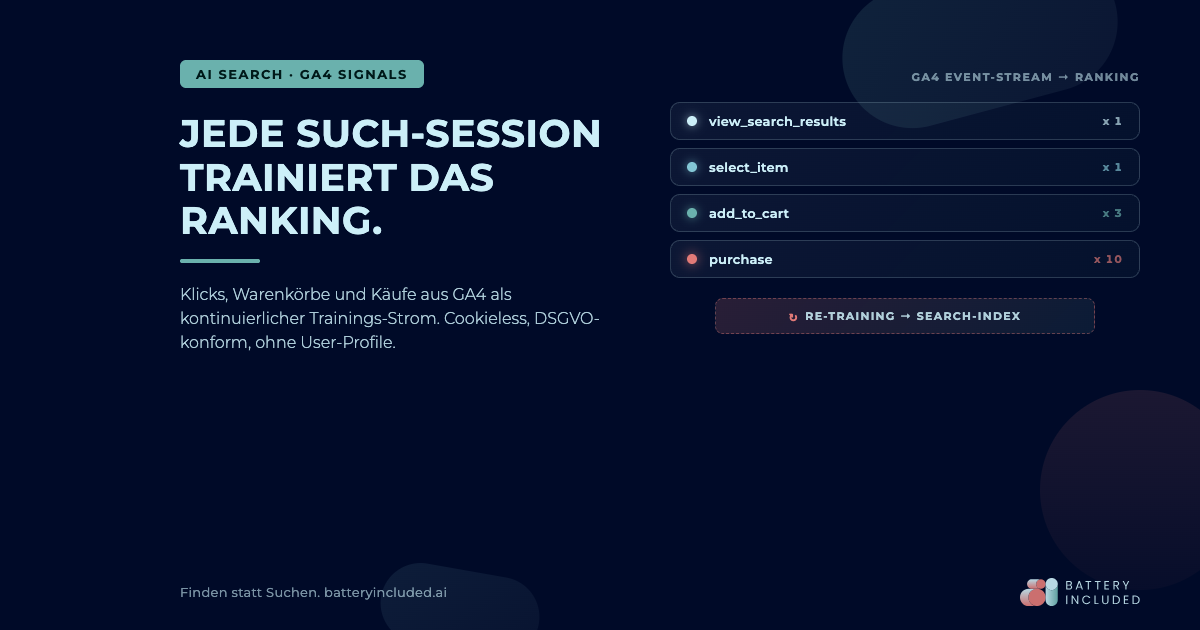
Eine in der Praxis bewährte Gewichtung sieht so aus. Klick (select_item) bekommt das Basis-Gewicht eins. Add-to-Cart bekommt das Gewicht drei, weil es eine deutlich klarere Kauf-Absicht ausdrückt. Checkout-Start (begin_checkout) bekommt das Gewicht fünf, weil die Entscheidungs-Phase erreicht ist. Kauf (purchase) bekommt das Gewicht zehn, weil das Signal die härteste mögliche Bestätigung ist.
Aus diesen Gewichten wird pro Suchterm und Produkt ein gewichteter Behavior-Score berechnet. Eine Anfrage "Sommerkleid blau" mit für Produkt A fünfhundert Klicks, sechzig Add-to-Carts, zwanzig Checkout-Starts und zwölf Käufen erzeugt einen Behavior-Score von 500 mal 1 plus 60 mal 3 plus 20 mal 5 plus 12 mal 10, gleich 900. Produkt B mit hundertfünfzig Klicks, achtzig Add-to-Carts, dreißig Checkout-Starts und achtzehn Käufen kommt auf 150 plus 240 plus 150 plus 180, gleich 720. Obwohl Produkt A mehr als dreimal so viele Klicks hat, ist Produkt B in der gewichteten Schicht nur leicht unterlegen, weil seine Conversion-Tiefe besser ist. Die Gewichtung verhindert, dass Klick-Volumen ohne Kauf-Tiefe das Ranking dominiert.
Die konkreten Gewichte sind nicht universell. Sie müssen pro Shop kalibriert werden. Ein Sortiment mit hochpreisigen Produkten, deren Kauf-Entscheidung Tage oder Wochen dauert, hat eine andere Add-to-Cart-zu-Kauf-Konversion als ein FMCG-Shop mit Impuls-Käufen. In der Praxis wird die Gewichtung in der ersten Setup-Phase auf den Standardwerten gesetzt und nach acht bis zwölf Wochen anhand der A/B-Test-Ergebnisse nachjustiert. Wer die NDCG@5-Metrik aus dem Hybrid-Ranking-Kontext mit der Gewichtung kalibriert, findet meist innerhalb von zwei Iterationen die für den Shop passende Konfiguration.
Eine weitere Verfeinerung ist die Retour-Korrektur. Ein Kauf, der retourniert wird, ist ein schwächeres Signal als ein Kauf, der behalten wird. In Sortimenten mit hohen Retour-Quoten (Mode, Schuhe, Elektronik) ist die Retour-Korrektur kein Nice-to-have, sondern eine strukturelle Notwendigkeit. Die Pipeline integriert die Retour-Daten aus dem ERP und reduziert das Kauf-Gewicht um den Faktor 1 minus Retour-Quote. Wer in einem Mode-Shop diese Korrektur weglässt, bekommt ein Ranking, das systematisch retour-anfällige Produkte hochpinnt.
Die ERP-Integration ist damit nicht nur für Verfügbarkeits-Daten relevant. Sie ist auch für die Behavior-Signal-Korrektur entscheidend. Wir haben die ERP-Anbindung im Beitrag zur ERP-Daten-Integration in die Shop-Suche im Detail beschrieben und zeigen dort die Daten-Flüsse für Verfügbarkeit, Marge und Retour-Quote als gemeinsame Quelle.
Cold-Start auf Long-Tail-Queries
Was passiert mit Such-Anfragen, für die es kaum Behavior-Daten gibt?
Nicht jede Such-Anfrage hat genug Trainings-Daten, um statistisch belastbar zu sein. Wir hatten im Beitrag zum 80:20-Auto-Ranking-Prinzip beschrieben, dass etwa zwanzig Prozent der Such-Anfragen achtzig Prozent des Such-Volumens erzeugen. Die übrigen achtzig Prozent der Anfragen sind Long-Tail, mit niedrigen Volumina pro einzelner Anfrage. Für diese Long-Tail-Queries sind die GA4-Aggregate dünn, oft nur eine Handvoll Klicks und null Käufe pro Monat.
Wer die Behavior-Schicht naiv auf Long-Tail-Queries anwendet, bekommt zwei Probleme. Erstens, Rauschen. Eine Anfrage mit fünf Sessions im Monat liefert keine statistisch belastbare Klick-Verteilung. Der Behavior-Score schwankt zwischen Iterationen stark und destabilisiert das Ranking. Zweitens, Lock-in. Wenn ein Produkt durch einen zufälligen frühen Klick auf den ersten Platz kommt, bekommt es durch seine Position weitere Klicks, die das Ranking zementieren, obwohl die Daten-Basis nicht aussagekräftig ist.
Die Lösung ist eine Vertrauens-Skalierung. Pro Suchterm wird ein Konfidenz-Wert berechnet, der mit der Anzahl der Sessions wächst. Bei Anfragen mit weniger als zwanzig Sessions im Aggregations-Zeitraum bekommt der Behavior-Score ein sehr niedriges Gewicht und das Ranking fällt im Wesentlichen auf den Text- und Semantik-Score zurück. Bei Anfragen mit zwischen zwanzig und zweihundert Sessions skaliert das Behavior-Gewicht linear hoch. Bei Anfragen mit mehr als zweihundert Sessions erreicht das Behavior-Gewicht das volle konfigurierte Niveau.
Eine zweite Lösung ist die Suchterm-Cluster-Aggregation. Long-Tail-Queries werden semantisch geclustert, sodass ähnliche Anfragen ihre Aggregat-Daten teilen. Die Anfragen "Sommerkleid blau", "blaues Sommerkleid" und "Kleid Sommer blau" werden im Cluster zusammengefasst und teilen einen gemeinsamen Behavior-Score. Damit profitieren einzelne Long-Tail-Queries von den Signalen ihres Clusters, ohne dass die individuelle statistische Schwäche das Ranking destabilisiert. Diese Cluster-Bildung läuft über die semantische Schicht, die wir im Beitrag Was ist semantische Suche? im Detail beschrieben haben.
Eine dritte Lösung ist die Produkt-Cluster-Aggregation. Auch wenn die Anfrage einzeln zu dünn ist, lassen sich die Behavior-Signale auf Produkt-Cluster-Ebene aggregieren. Eine Anfrage "Sommerkleid mit Punkten" ohne ausreichende eigene Signale erbt die Behavior-Aggregate der Produkt-Kategorie "Sommerkleider", angereichert mit dem semantischen Filter "mit Punkten". Diese Übertragung ist die gleiche Mechanik, die auch das Cold-Start-Problem für neue Produkte löst.
Die drei Lösungen werden in der Praxis kombiniert. Eine moderne Pipeline berechnet pro Suchterm sowohl die direkte Aggregation als auch die Cluster-Aggregate. Der Behavior-Score nutzt die Cluster-Aggregate für Long-Tail-Queries und die direkten Aggregate für Hot-Queries. Die Schwelle dazwischen ist die Konfidenz-Skalierung, die fließend zwischen beiden interpoliert. Wer diese Mechanik nicht implementiert, bekommt entweder ein destabilisiertes Long-Tail-Ranking oder ein eingefrorenes Long-Tail-Ranking, beides ist suboptimal.
Hot-Queries: das Pareto-Zwanzig-Prozent
Wo im Such-Volumen liegen eigentlich die datenreichen Hot-Queries?
Auf der anderen Seite der Verteilung liegen die Hot-Queries. Etwa zwanzig Prozent der Such-Anfragen tragen achtzig Prozent des Such-Volumens. Diese Anfragen liefern reichhaltige GA4-Aggregate, oft mit tausenden Sessions pro Monat. Hier ist die statistische Belastbarkeit hoch, und die Behavior-Schicht kann mit dem vollen konfigurierten Gewicht arbeiten.
Für Hot-Queries lohnt eine zusätzliche Verfeinerung. Die direkte Aggregation pro Suchterm wird ergänzt durch eine Position-aware Aggregation, die die Klickrate pro Position berücksichtigt. Die erste Treffer-Position bekommt typisch eine Click-Through-Rate von dreißig bis fünfzig Prozent, die zweite Position fünfzehn bis fünfundzwanzig Prozent, die dritte Position acht bis fünfzehn Prozent. Diese Verteilung ist die Position-Bias-Kurve, die in jeder Liste mit Lese-Reihenfolge auftaucht.
Die Position-aware Aggregation korrigiert die rohen Klick-Daten um den Positions-Effekt. Ein Produkt, das auf Platz eins steht und tausend Klicks bekommt, wird gegen die erwartete CTR der Position eins verglichen. Wenn die erwartete CTR vierzig Prozent ist und die tatsächliche fünfzig Prozent, hat das Produkt einen Lift von zehn Prozentpunkten über der Norm. Dieser Lift ist das eigentliche Trainings-Signal, nicht die rohe Klick-Zahl.
Diese Korrektur ist die mathematische Grundlage für die Anti-Lock-in-Strategie. Ohne sie würde das oberste Produkt durch seine Position immer mehr Klicks bekommen und immer höher gerankt werden. Mit ihr wird die Position-Bias herausgerechnet, und das Ranking lernt aus dem tatsächlichen Verhaltens-Lift, nicht aus dem Positions-Effekt.
Die Implementierung ist nicht trivial. Die erwartete CTR pro Position muss pro Sortimenttyp und pro Anfragen-Klasse kalibriert werden, weil ein Mode-Shop andere Klick-Verteilungen hat als ein Werkzeug-Shop. Eine Mid-Enterprise-Pipeline berechnet die erwartete CTR aus historischen Daten und aktualisiert sie monatlich. Wer diese Mechanik nicht hat, kann mit einer Standard-Kurve aus der E-Commerce-Literatur arbeiten, hat dann aber eine Genauigkeits-Lücke gegenüber der eigenen Daten-Realität.
Recency Decay: das Saison-Problem
Verlieren Behavior-Daten mit der Zeit an Aussagekraft?
Behavior-Daten haben eine zeitliche Dimension. Ein Klick aus dem August hat im Dezember weniger Aussagekraft als ein Klick aus dem Oktober. Ein Sommerkleid, das im Juni Bestseller war, ist im November irrelevant. Die Pipeline muss diese zeitliche Dimension abbilden, sonst überleben Saison-Effekte aus der vergangenen Saison im aktuellen Ranking.
Die Standard-Lösung ist ein exponentieller Decay über das Aggregations-Fenster. Klicks aus den letzten sieben Tagen werden mit Faktor eins gewichtet, Klicks aus dem letzten Monat mit Faktor 0,7, Klicks aus dem letzten Quartal mit Faktor 0,3, Klicks aus den letzten neunzig Tagen mit Faktor 0,1 und ältere Klicks werden ausgefiltert. Diese Decay-Funktion sorgt dafür, dass die Behavior-Signale primär aus dem aktuellen Zeitraum kommen, mit einer abnehmenden Berücksichtigung der älteren Historie.
Die Decay-Konstante ist sortiments-abhängig. Ein FMCG-Shop mit weitgehend stabilen Klick-Mustern kann mit einem flacheren Decay arbeiten, weil die Klick-Verteilung von letztem Quartal eine ähnliche Aussagekraft hat wie die der letzten Woche. Ein Mode-Shop mit Saison-Wechseln braucht einen steileren Decay, weil die Klick-Verteilung von vor sechs Wochen in der neuen Saison kaum noch aussagekräftig ist. Eine konkrete Anpassung der Decay-Konstante pro Sortiment ist nach drei bis sechs Monaten Echtdaten möglich, vorher arbeitet die Pipeline mit einer Standard-Konfiguration.
Ein zweiter zeitlicher Effekt ist die Saison-Kurven-Gewichtung. Behavior-Signale aus dem letzten Jahr werden relativ zur aktuellen Saisonalität berücksichtigt. Ein Wintermantel-Bestseller aus dem letzten Dezember bekommt in diesem November einen Saison-Bonus, weil die Saisonalität wieder einsetzt. Ein Sommerkleid-Bestseller aus dem letzten Juni bekommt im November keinen Saison-Bonus, weil die Saisonalität nicht greift. Diese Saison-Kurven-Gewichtung ist eine zweite Verfeinerung, die in Shops mit starker Saisonalität die Recency-Schicht ergänzt.
Wer beide zeitlichen Mechaniken kombiniert, hat ein Ranking, das auf aktuelle Klick-Verteilungen reagiert, aber bei wiederkehrenden Saison-Effekten die historische Bestseller-Information mitnimmt. Diese Kombination ist die operative Grundlage für ein Saison-fähiges Ranking, das ohne manuelle Pflege auf wiederkehrende Verkaufszyklen reagiert. Die manuelle Schicht aus dem 80:20-Auto-Ranking-Prinzip kann darauf aufsetzen und punktuell Saison-Eröffnungen vorne pinnen, ohne dass die Auto-Schicht die Saison-Mechanik komplett vergisst.
Anti-Lock-in: wenn das Top-Produkt sich selbst zementiert
Welche Gefahr droht, wenn ein Top-Produkt sich über seine eigene Position immer weiter nach oben klickt?
Eine der heimtückischsten Pathologien in Behavior-getriebenen Ranking-Systemen ist der Lock-in-Effekt. Ein Produkt, das durch eine frühe Welle an Klicks auf den ersten Platz kommt, bekommt durch seine Position immer mehr Klicks. Diese Klicks verstärken den Behavior-Score, der das Produkt weiter oben hält. Die Position bringt mehr Klicks, die Klicks halten die Position. Das System konvergiert auf einen Lock-in, in dem das Top-Produkt sich selbst zementiert, auch wenn semantisch oder qualitativ bessere Alternativen im Sortiment vorhanden sind.
Der Lock-in ist nicht ein Bug, sondern eine strukturelle Konsequenz der naiven Behavior-Aggregation. Er ist die mathematische Eigenschaft jedes Systems, in dem Position und Klick-Wahrscheinlichkeit positiv korrelieren. Ohne aktive Gegenmaßnahmen führt jedes behavior-getriebene Ranking irgendwann in einen Lock-in, der die langfristige Sortier-Qualität degradiert und neue oder verbesserte Produkte unsichtbar macht.
Drei Anti-Lock-in-Strategien sind in der Praxis erprobt. Erste Strategie: Position-Bias-Korrektur, wie im Hot-Queries-Abschnitt beschrieben. Die rohen Klick-Daten werden um die erwartete CTR der Position korrigiert, sodass nur der echte Lift über die Position-Norm das Ranking-Signal liefert. Diese Korrektur ist die strukturelle Basis der Anti-Lock-in-Logik. Sie ist nicht ein Add-on, sie ist die Voraussetzung dafür, dass die Behavior-Schicht überhaupt lernen kann.
Zweite Strategie: Exploration-Exploitation-Balance. Ein kleiner Anteil der Sessions (typisch fünf bis zehn Prozent) sieht eine randomisierte Treffer-Reihenfolge, in der nicht das aktuell oberste Produkt auf Platz eins steht, sondern ein semantisch passendes Alternativ-Produkt. Die Klicks dieser Exploration-Sessions liefern unverzerrte Daten über die Wett-Bewerbsfähigkeit der Alternativen. Wenn ein Alternativ-Produkt in den Exploration-Sessions eine bessere CTR zeigt als das aktuelle Top-Produkt in den normalen Sessions, wird der Ranking-Wechsel vollzogen. Diese Mechanik ist die direkte Übersetzung der Multi-Armed-Bandit-Logik in den E-Commerce-Such-Kontext.
Dritte Strategie: Counterfactual Learning. Die Pipeline berechnet, was ein Produkt an Klicks bekommen hätte, wenn es auf einer anderen Position gestanden hätte. Diese hypothetischen Klick-Werte werden aus den realen Klick-Verteilungen und der Position-Bias-Kurve abgeleitet. Wenn ein Produkt auf Platz drei eine außerordentlich hohe CTR zeigt, hätte es auf Platz eins voraussichtlich noch mehr Klicks bekommen. Die Counterfactual-Schicht lernt aus diesem hypothetischen Lift und kann das Ranking entsprechend anpassen, ohne dass eine reale Exploration-Session nötig ist.
Diese drei Strategien werden in der Praxis kombiniert. Position-Bias-Korrektur ist die strukturelle Basis, Exploration-Exploitation ist die Verteilungs-Diversifikation, Counterfactual Learning ist die mathematische Verfeinerung. Wer keine dieser drei Strategien implementiert, baut ein Ranking, das im Zeitverlauf in einen Lock-in konvergiert und die Conversion-Rate langfristig degradiert. Wer alle drei implementiert, hat ein Ranking, das sich kontinuierlich neu kalibriert und Verbesserungs-Potenzial im Sortiment erkennt.
In einer integrierten Such-Architektur sind diese Anti-Lock-in-Mechaniken im Kern-Algorithmus kodiert. Sie laufen ohne Marketing-Eingriff und ohne manuelle Pflege. In einer fragmentierten Architektur, in der die Behavior-Aggregation und das Ranking in getrennten Systemen leben, sind sie kaum durchsetzbar, weil die Counterfactual-Berechnung den vollen Zugang zur Ranking-Logik braucht.
A/B-Test-Setup: NDCG, MRR und die echte Business-Metrik
Kann ich Änderungen an der Behavior-Aggregation einfach live schalten?
Jede Änderung an der Behavior-Aggregation muss A/B-getestet werden. Die Änderung kann theoretisch besser sein als die Vorgänger-Version, sie kann praktisch schlechter sein, weil sie eine unerwartete Interaktion mit dem Sortiment oder mit dem semantischen Score erzeugt. Ohne A/B-Test ist die Behavior-Schicht eine Hypothese, mit A/B-Test ist sie eine Evidenz-basierte Engineering-Disziplin.
Die drei zentralen Metriken sind NDCG, MRR und Search Revenue per Session. NDCG@5 misst die Ranking-Qualität in den ersten fünf Treffern, der Bereich, in dem die meisten Klicks fallen. MRR misst die durchschnittliche Position des ersten gekauften Produkts. Search Revenue per Session ist die direkte Business-Metrik, die alle vorherigen Schritte in eine Geld-Zahl überführt.
Ein sauberer A/B-Test braucht drei Bedingungen. Erstens, konsistente Session-Bucketisierung. Ein User darf nicht innerhalb einer Session zwischen Variante A und Variante B wechseln, sonst ist die Daten-Basis verfälscht. Zweitens, ausreichendes Daten-Volumen pro Variante. Faustregel: mindestens zehntausend Suchanfragen pro Variante über zwei bis vier Wochen. Drittens, Kontrolle für Saisonalität. Ein Test, der über einen Saison-Wechsel läuft, mischt die Saisonalität in das Ergebnis und liefert keine sauberen Vergleichswerte.
Für die GA4-Behavior-Pipeline gibt es eine zusätzliche Herausforderung. Die Pipeline lernt kontinuierlich, sodass die Variante B nach zwei Wochen andere Behavior-Aggregate hat als die Variante A. Diese Lern-Asymmetrie kann das A/B-Test-Ergebnis verzerren, wenn die Pipeline der Variante B Schneller-Lerne-Funktionen oder andere Aggregations-Logik hat. Die saubere Lösung ist eine eingefrorene Behavior-Aggregation während der Testphase, sodass beide Varianten auf demselben statischen Aggregat-Stand arbeiten und nur die Ranking-Logik unterschiedlich ist. Nach dem Test wird die Lern-Aktualisierung wieder eingeschaltet.
Eine zweite Verfeinerung ist die Stratifikation nach Anfragen-Klasse. Hot-Queries und Long-Tail-Queries reagieren unterschiedlich auf Ranking-Änderungen. Eine Verfeinerung der Cold-Start-Logik wirkt primär auf Long-Tail-Queries, eine Verfeinerung der Position-Bias-Korrektur wirkt primär auf Hot-Queries. Wer nicht stratifiziert, mischt die beiden Effekte und sieht im Gesamt-Average die Veränderung nicht. Wer stratifiziert, kann die Wirkung pro Anfragen-Klasse separat messen und gezielt optimieren.
Eine konkrete Erfahrung aus einem Kunden-Projekt im Edelmetall-Versand zeigt die Größenordnung. Ein Shop mit einer existierenden BM25-Schicht ergänzte die GA4-Behavior-Aggregation mit Recency Decay und Position-Bias-Korrektur. Nach acht Wochen A/B-Test stieg der NDCG@5 von 0,46 auf 0,63, der MRR von 0,23 auf 0,38, und die Search Revenue per Session legte um neunzehn Prozent zu. Diese Lifts sind nicht universell, sie sind die Größenordnung, die in einem Mid-Enterprise-Shop mit sauberer GA4-Implementierung und ausreichend Volumen typischerweise erreicht wird.
"Was uns geholfen hat, war die Sicht auf die Treffer-Listen in Echtzeit. Wir konnten zum ersten Mal sehen, welche Produkte für unsere wichtigsten Such-Anfragen tatsächlich oben standen, und wo unsere Saison-Aktionen liefen, ohne dass wir sie raten mussten. Die Möglichkeit, gezielt einzugreifen ohne den Algorithmus komplett zu ersetzen, hat uns die Steuerung zurückgegeben, ohne die wir vorher operativ eingeschränkt waren."
Solit Group GmbH
Im Edelmetall-Versand ist die Verbindung von Behavior-Signalen und Preis-Volatilität besonders eng. Ein Goldpreis-Sprung verändert die Klick-Verteilung innerhalb von Stunden, und die Pipeline muss diese Verschiebung in das Ranking überführen, bevor die Saison-Kurve oder der Standard-Decay sie eingearbeitet hat.
Pipeline-Architektur: GA4 → BigQuery → Embedding-Trainer → Search-Index
Aus welchen Bausteinen besteht die GA4-Behavior-Pipeline technisch?
Die operative Pipeline besteht aus vier Schichten. Erste Schicht: der GA4-Event-Stream selbst. Er wird über die Standard-GA4-Implementierung im Shop generiert, über einen Server-Side-Tag-Manager validiert und über die BigQuery-Integration in das Daten-Warehouse exportiert. Diese Integration ist seit dem GA4-Standard 2023 für alle GA4-Eigenschaften nativ verfügbar und liefert die Event-Daten typisch mit einer Verzögerung von zwei bis vier Stunden.
Zweite Schicht: die Aggregation in BigQuery. Eine SQL-Pipeline läuft täglich oder stündlich und aggregiert pro Suchterm und Produkt die gewichteten Behavior-Scores. Die Pipeline berechnet sowohl die direkten Aggregate als auch die Cluster-Aggregate, die Position-aware Korrektur und den Recency Decay. Das Ergebnis ist eine Behavior-Tabelle mit einigen hundert MB Größe für einen typischen Mid-Enterprise-Shop, die als Grundlage für das Ranking dient.
Dritte Schicht: der Embedding-Trainer. Diese Schicht nutzt die Behavior-Aggregate, um die semantischen Embeddings zu kalibrieren. Produkte, die für eine Suchterm-Klasse hohe Behavior-Scores haben, bekommen eine engere Embedding-Nähe zur Klasse. Diese Kalibrierung läuft nachts oder mehrmals täglich, je nach Update-Frequenz des Sortiments. Sie sorgt dafür, dass das semantische Ranking nicht nur auf statischen Produkt-Texten basiert, sondern auf der dynamischen Verhaltens-Realität.
Vierte Schicht: der Search-Index. Der berechnete Behavior-Score wird in den Such-Index zurückgespielt und in den Hybrid-Score eingewoben. Die Update-Frequenz hängt von der Sortiments-Dynamik ab. Stabile Sortimente kommen mit einem täglichen Update aus, dynamische Sortimente mit Stunden-Frequenz. In beiden Fällen ist die Synchronisations-Latenz transparent dokumentiert, sodass das Marketing weiß, wann eine Sortier-Änderung tatsächlich live ist.
Diese vier Schichten sind in einer integrierten Architektur ein Zusammenhang. In einer fragmentierten Architektur, in der die Behavior-Aggregation und der Search-Index in getrennten Systemen leben, ist die vierte Schicht das Problem. Der Behavior-Index muss in das Such-Backend gespielt werden, das oft kein Interface für externe Score-Quellen hat. In dieser Konstellation ist die GA4-Integration ein Engineering-Projekt von typisch fünfzig bis hundert Personentagen, das in vielen Mittelstands-Shops nicht angegangen wird, weil die Engineering-Kapazität für andere Projekte gebunden ist.
In einer integrierten Architektur wie Volt Search® ist die Pipeline native. Der Behavior-Score läuft auf derselben Daten-Foundation wie der Text- und Semantik-Score, und die Synchronisation zwischen den Schichten ist im System verankert. Marketing sieht in einem Dashboard, welche Behavior-Aggregate gerade in das Ranking einfließen, mit welcher Verzögerung und mit welcher Gewichtung. Diese Transparenz ist die operative Voraussetzung dafür, dass die GA4-Schicht überhaupt produktiv genutzt werden kann.
Integration mit AI Recommendations: gleiche Daten, zwei Anwendungen
Lassen sich die GA4-Behavior-Aggregate auch über die Suche hinaus nutzen?
Die GA4-Behavior-Aggregate sind nicht nur für das Such-Ranking nützlich. Sie sind auch die Daten-Foundation für die AI Recommendations, die das Cross-Selling und die Similar-Search-Vorschläge auf der Produkt-Detail-Seite treiben. Wir haben die Mechanik der Empfehlungs-Schicht im Beitrag zur AI Recommendations Similar Search im Detail beschrieben.
Die Logik dahinter ist die Daten-Wiederverwendung. Die Aggregat-Tabelle pro Suchterm und Produkt liefert eine Klick-Verteilung, aus der sich die produkt-zu-produkt-Affinität ableiten lässt. Welche Produkte werden für ähnliche Anfragen häufig zusammen geklickt? Welche werden im selben Warenkorb zusammen gefunden? Welche werden in aufeinanderfolgenden Sessions des gleichen Klick-Musters interagiert? Diese Affinitäts-Matrix ist der Trainings-Input für die Empfehlungs-Schicht.
Die Daten-Wiederverwendung hat zwei Vorteile. Erstens, sie spart Engineering-Aufwand. Die Pipeline wird einmal gebaut, einmal validiert, einmal überwacht. Sie liefert Daten für zwei verschiedene Anwendungen ohne Dopplung. Zweitens, sie sorgt für Konsistenz. Wenn die Such-Schicht und die Empfehlungs-Schicht auf demselben Trainings-Stream laufen, sind ihre Outputs konsistent. Ein Produkt, das in der Suche hoch gerankt wird, taucht auch in den Empfehlungen für ähnliche Produkte auf. Ein Produkt, das in der Suche absteigt, verliert auch in den Empfehlungen an Sichtbarkeit.
Diese Konsistenz ist in fragmentierten Stacks selten. Wenn die Suche bei einem Anbieter läuft und die Empfehlungs-Schicht bei einem zweiten, leben beide auf unterschiedlichen Daten-Aggregaten. Sie können sich widersprechen, weil sie aus unterschiedlichen Trainings-Quellen lernen. In der integrierten Architektur ist dieser Widerspruch ausgeschlossen, weil beide Schichten auf derselben Behavior-Foundation laufen.
"BatteryIncluded.ai ist genau das, was man sich von moderner E-Commerce-Technologie wünscht: blitzschnelle Suche auch bei über 50.000 Produkten, volle Anpassbarkeit für komplexe Anforderungen, und ein Support, der nicht nur reagiert, sondern wirklich versteht. Stabil, skalierbar, zukunftssicher."
Österreichischer Bundesverlag Schulbuch GmbH & Co. KG
Im B2B-Schulbuch-Versand mit Saison-Spitzen im August ist die Pipeline-Stabilität besonders wichtig, weil die Hauptlast in einer Drei-Wochen-Periode anfällt und die Behavior-Aggregate in dieser Phase mit hohem Volumen reinkommen. Die Pipeline muss in dieser Phase ohne Engineering-Intervention skalieren und gleichzeitig die Saison-Kurven-Gewichtung sauber abbilden.
Was Sie diese Woche tun können
Womit fange ich konkret an, wenn mein Ranking heute noch nicht auf GA4-Signalen lernt?
Wenn Sie heute eine Shop-Suche betreiben, deren Ranking nicht auf GA4-Behavior-Signalen lernt, ist der pragmatische Einstieg in fünf Schritten.
Schritt eins ist die GA4-Event-Diagnose. Prüfen Sie in Ihrem GA4-Konto, ob die sieben relevanten Events (view_search_results, select_item, view_item, add_to_cart, begin_checkout, purchase, search) sauber implementiert sind. Prüfen Sie insbesondere, ob die Such-Terme als event_parameter mitgesendet werden und ob die item_list_id die Such-Ergebnis-Liste eindeutig identifiziert. Bei vielen Shops fehlt mindestens eines dieser drei Elemente. Ohne sie ist die Behavior-Aggregation nicht möglich.
Schritt zwei ist die BigQuery-Anbindung. Aktivieren Sie den BigQuery-Export in Ihrer GA4-Eigenschaft. Dieser Export ist seit dem GA4-Standard für alle GA4-Konten verfügbar und liefert die Roh-Events in einer typischen Latenz von zwei bis vier Stunden. Wer keinen BigQuery-Export aktiviert hat, kann auf die GA4-Reporting-API ausweichen, hat aber Limits auf die Roh-Events und kann die Cluster-Aggregation nur eingeschränkt fahren.
Schritt drei ist die Aggregations-Pipeline. Schreiben Sie eine SQL-Pipeline in BigQuery, die pro Suchterm und Produkt die gewichteten Behavior-Scores berechnet. Implementieren Sie die Gewichtungen (Klick gleich 1, Cart gleich 3, Checkout gleich 5, Kauf gleich 10), die Recency-Decay-Funktion und die Konfidenz-Skalierung für Long-Tail-Queries. Diese Pipeline ist die operative Grundlage für die GA4-Integration. In einer integrierten Such-Architektur ist sie bereits eingebaut, in einer fragmentierten Architektur ist sie ein Projekt von zwei bis vier Personentagen für die Erst-Version.
Schritt vier ist die Score-Integration in das Ranking. Spielen Sie die Behavior-Tabelle in den Such-Index zurück und kombinieren Sie sie mit dem Text- und Semantik-Score. Die Gewichtung sollte initial bei dreißig Prozent Behavior, vierzig Prozent Text, dreißig Prozent Semantik liegen, mit der Möglichkeit zur Nachkalibrierung anhand der A/B-Test-Ergebnisse. Wer mit klassischen Open-Source-Indizes wie Elasticsearch arbeitet, kann die Behavior-Tabelle als Custom-Boost-Funktion implementieren. Wer mit Volt Search® arbeitet, hat diese Schicht nativ verfügbar.
Schritt fünf ist die A/B-Test-Infrastruktur. Ohne saubere Session-Bucketisierung sind die Ranking-Änderungen nicht messbar. Investieren Sie eine Sprint-Phase in das Test-Setup, definieren Sie die Erfolgs-Metriken (NDCG@5, MRR, Search Revenue per Session) und richten Sie das wöchentliche Reporting auf diese Metriken aus. Damit ist die Behavior-Schicht nicht ein einmaliger Wechsel, sondern eine kontinuierliche Optimierungs-Disziplin.
Diese fünf Schritte sind unabhängig davon sinnvoll, ob Sie auf eine spezialisierte AI-Such-Infrastruktur wechseln oder eine bestehende Lösung erweitern. Was sie nicht ersetzen können, ist die operative Reife einer Plattform, die die GA4-Anbindung, die Aggregations-Pipeline, die Anti-Lock-in-Mechaniken und das Cohort-Aggregat-Modell aus einer Hand mitbringt. Eine vertiefte Behandlung der Synonym-Pflege im Behavior-Lern-Kontext werden wir in einem späteren Beitrag dieser Serie behandeln.
Häufige Fragen (FAQ)
Welche GA4-Events fließen in das Such-Ranking ein?
Sieben Events tragen das Trainings-Signal. view_search_results liefert die Such-Anfrage und die ausgespielte Treffer-Liste. select_item liefert das primäre Klick-Signal pro Suchterm und Produkt. view_item liefert die Verifikation, dass die Produkt-Detail-Seite geöffnet wurde. add_to_cart liefert die Kauf-Absicht. begin_checkout liefert die Entscheidungs-Phase. purchase liefert die härteste Bestätigung. search ergänzt view_search_results mit zusätzlichen Such-Parametern. In der Praxis sind view_search_results, select_item und purchase die Hauptlast-Träger, die übrigen vier sind Verfeinerungs-Schichten. Die Events werden pro Suchterm und Produkt aggregiert und in einen gewichteten Behavior-Score umgerechnet, der das Such-Ranking beeinflusst.
Wie wird die GA4-Behavior-Pipeline DSGVO-konform aufgebaut?
Die Pipeline aggregiert auf Cohort-Ebene, nicht auf User-Ebene. Pro Suchterm und Produkt werden die Events aller Sessions summiert. User-IDs werden in der Aggregations-Stufe entfernt, bevor die Daten den Daten-Warehouse-Layer verlassen. Die Aggregat-Tabelle enthält keine personenbezogenen Daten und braucht damit keinen Cookie-Consent. Diese Cookieless-Aggregation ist die DSGVO-konforme Variante der Behavior-getriebenen Ranking-Optimierung. Sie kann keine personalisierten Rankings produzieren, hat dafür aber keinen Consent-Bedarf und keine Privacy-Compliance-Last. Für DACH-Shops mit regelmäßigen Datenschutz-Audits ist die Cohort-Aggregation der praktikable Mittelweg.
Wie hoch sollten die Gewichte für Klick, Cart, Checkout und Kauf sein?
Eine in der Praxis bewährte Gewichtung lautet Klick gleich 1, Add-to-Cart gleich 3, Checkout-Start gleich 5, Kauf gleich 10. Diese Gewichte spiegeln die Stärke des jeweiligen Signals als Kauf-Absichts-Indikator. Ein Klick kann eine Fehlnavigation oder eine Neugier-Inspektion sein, ein Kauf ist die härteste Bestätigung. Die konkreten Gewichte müssen pro Shop kalibriert werden. Hochpreisige Sortimente mit langen Entscheidungs-Phasen brauchen eine andere Add-to-Cart-zu-Kauf-Konversion als FMCG-Sortimente mit Impuls-Käufen. In der ersten Setup-Phase wird mit den Standardwerten gearbeitet, nach acht bis zwölf Wochen wird die Gewichtung anhand der NDCG@5- und MRR-Metriken nachjustiert.
Wie geht die Pipeline mit Long-Tail-Queries um, die wenig Daten haben?
Drei Strategien lösen das Cold-Start-Problem auf Long-Tail-Queries. Erstens, Konfidenz-Skalierung. Bei Anfragen mit weniger als zwanzig Sessions im Aggregations-Zeitraum bekommt der Behavior-Score ein niedriges Gewicht und das Ranking fällt auf den Text- und Semantik-Score zurück. Zweitens, Suchterm-Cluster-Aggregation. Semantisch ähnliche Anfragen teilen ihre Aggregat-Daten, sodass einzelne Long-Tail-Queries von den Signalen ihres Clusters profitieren. Drittens, Produkt-Cluster-Aggregation. Die Behavior-Signale auf Produkt-Kategorie-Ebene liefern eine Initialisierung für neue oder selten gesuchte Anfragen. Die drei Strategien werden kombiniert und fließend zwischen einander interpoliert.
Was ist der Lock-in-Effekt im Behavior-getriebenen Ranking?
Ein Produkt, das durch eine frühe Welle an Klicks auf den ersten Platz kommt, bekommt durch seine Position weitere Klicks. Diese Klicks verstärken den Behavior-Score, der das Produkt weiter oben hält. Die Position bringt mehr Klicks, die Klicks halten die Position. Das System konvergiert auf einen Lock-in, in dem das Top-Produkt sich selbst zementiert, auch wenn semantisch oder qualitativ bessere Alternativen vorhanden sind. Der Lock-in ist eine strukturelle Konsequenz der naiven Behavior-Aggregation. Drei Anti-Lock-in-Strategien sind in der Praxis erprobt: Position-Bias-Korrektur, Exploration-Exploitation-Balance und Counterfactual Learning. In einer integrierten Such-Architektur sind sie im Kern-Algorithmus kodiert.
Wie häufig sollte das Behavior-Update in den Such-Index gespielt werden?
Die Update-Frequenz hängt von der Sortiments-Dynamik und dem Volumen der täglichen Such-Anfragen ab. Stabile Sortimente mit moderatem Volumen kommen mit einem täglichen Update aus. Dynamische Sortimente mit hohem Volumen und Saison-Effekten profitieren von einem Stunden-Frequenz-Update. In beiden Fällen ist die Synchronisations-Latenz transparent zu dokumentieren, sodass das Marketing weiß, wann eine Sortier-Änderung tatsächlich live ist. Echtzeit-Updates sind technisch möglich, in der Praxis aber selten nötig, weil die Klick-Verteilung über Stunden hinweg statistisch stabil bleibt.
Was misst NDCG@5 in der Behavior-getriebenen Such-Optimierung?
NDCG steht für Normalized Discounted Cumulative Gain. Er misst, wie gut die Reihenfolge der Treffer-Liste mit der idealen Reihenfolge übereinstimmt. NDCG@5 betrachtet nur die ersten fünf Treffer, weil im E-Commerce die meisten Klicks dort fallen. Die Werte liegen zwischen 0 und 1, höher ist besser. Eine Verbesserung von 0,42 auf 0,61 nach der GA4-Integration ist eine typische Größenordnung, die in Mid-Enterprise-Shops mit sauberer Implementierung erreicht wird. Wichtig: NDCG braucht eine Ground-Truth-Bewertung pro Treffer, in der Praxis aus Klick- oder Conversion-Daten abgeleitet. Die Berechnung läuft in der A/B-Test-Pipeline und liefert pro Variante einen Vergleichswert.
Wie verhält sich GA4-Behavior-Lernen zur manuellen Search-Merchandising-Schicht?
Die beiden Schichten ergänzen sich. Die GA4-Behavior-Schicht liefert die automatische Sortier-Qualität für tausende Anfragen pro Tag, ohne dass Marketing-Pflege nötig ist. Die manuelle Search-Merchandising-Schicht setzt punktuell für die volumenstärksten Anfragen ein, dort wo Saison, Marge oder Promo eine Sales-Steuerung jenseits der Behavior-Daten brauchen. In der Praxis arbeiten beide Schichten gemeinsam, mit einer Konflikt-Auflösungs-Logik, die manuelle Pin-Regeln gegen den Behavior-Score gewinnen lässt, aber die ML-Rückkopplung schützt, indem Klicks auf gepinnte Positionen mit niedrigerem Lern-Gewicht versehen werden. Diese Mechanik haben wir im Beitrag zum 80:20-Auto-Ranking-Prinzip ausführlich beschrieben.
Bereit für ein Ranking, das aus jeder Such-Session lernt?
Die GA4-Daten in Ihrem Shop sind heute schon da. Sie liegen im BigQuery-Export, im Reporting-Dashboard, im Quartals-Archiv. Was fehlt, ist die Pipeline, die diese Daten zurück in das Such-Ranking spielt, mit der richtigen Gewichtung von Klick, Cart, Checkout und Kauf, mit der Recency-Decay-Logik für Saison-Effekte, mit der Anti-Lock-in-Mechanik gegen Klick-Konzentration und mit der Cookieless-Aggregation für die DSGVO-Compliance. Volt Search® und AI Recommendations von BatteryIncluded sind als entkoppelte Infrastruktur konzipiert, in der diese Pipeline native eingebaut ist. Der Behavior-Score läuft auf derselben Daten-Foundation wie der Text- und Semantik-Score, die Anti-Lock-in-Strategien sind im Kern-Algorithmus kodiert, das Marketing-Dashboard zeigt in Echtzeit, welche Behavior-Aggregate gerade das Ranking beeinflussen. Cookieless, DSGVO-konforme KI, Made in Germany, ohne dass Sie User-Profile aufbauen oder eine eigene Behavior-Pipeline engineering müssen.
GA4 Transaktionsdaten als Ranking-Signal live sehen und erleben Sie an Ihren eigenen Produkt-, Such- und Behavior-Daten, wie aus dem Datenstrom Ihrer Such-Sessions ein kontinuierlicher Trainings-Strom für das Ranking wird, wie die Recency-Decay-Logik die Saison-Effekte automatisch abbildet, wie die Position-Bias-Korrektur den Lock-in verhindert und wie die integrierte Behavior-Foundation die Suche und die AI Recommendations konsistent versorgt. Ohne separate Pipelines, ohne User-Tracking, ohne Engineering-Projekt, das Ihre Sprint-Kapazität für ein halbes Jahr bindet.
